
摘要: OpenMAIC(Open Multi-Agent Interactive Classroom)是清华大学 MAIC 团队开源的多智能体互动课堂平台,可把一个主题或文档转换成包含课件、测验、互动模拟、项目制学习活动、AI教师和AI同学的课堂。清华大学2026年9月13日披露的数据显示,自3月开源至8月底,平台已汇聚超过58万名创作者,累计生成超过100万门AI课程,全球AI交互次数突破3400万次,覆盖154个国家和地区。本文以官方 v1.0.0 主线仓库为准,提供 Node.js 与 Docker 两种本地部署方法、模型与语音配置、课程生成流程、持久化方案、故障排查、安全边界,以及教育、企业培训和环保业务培训的落地模板。建议先在个人电脑或内网测试环境部署,确认模型成本、材料版权和数据策略后再面向多人开放。
核心结论
OpenMAIC 值得教育工作者、企业培训团队和 AI Agent 开发者试用,尤其适合把已有 PPT、PDF、音视频或一个培训主题快速变成可互动课堂。最稳妥的起步方式是先使用 Node.js 本地开发模式验证模型与课程质量,再用 Docker Compose 部署固定版本;公开服务前必须补齐真实用户认证、持久化隔离、API Key保护和内容审核。
- 它不是普通PPT生成器:OpenMAIC通过多智能体编排生成幻灯片、测验、交互式HTML、项目制学习内容,并让AI教师和AI同学参与讲解与讨论。
- 官方主线已进入v1.0.0阶段:2026年8月27日发布Agent工作台、可恢复会话、会话材料、课程工具和20个内置Skills。
- 本地部署门槛明确:官方要求 Node.js ≥22.19、pnpm ≥10;Docker可用
docker compose up --build启动。 - 开源许可证已变化:仓库在2026年6月从AGPL-3.0重新许可为MIT,当前应以仓库LICENSE为准。
- “本地部署”不自动等于“完全离线”:若使用OpenAI、Gemini、DeepSeek等云API,材料和请求仍可能发送到第三方;只有本地模型、语音、图像与解析链全部本地化,才接近完整离线。
OpenMAIC是什么:从MOOC到多智能体课堂
结论是:OpenMAIC的核心价值不是自动做几页PPT,而是把课程内容生成、课堂呈现和互动学习放在同一个Agent系统中。
官方将 OpenMAIC 定义为开放式多智能体互动课堂平台。用户输入课程主题,或上传文档、音频、视频等材料后,系统先规划课程结构,再生成不同类型的教学场景。课堂中可以存在AI教师、AI同学等角色:教师负责讲解、板书和推进课程,同学可以提问、讨论或制造认知冲突,学习者则参与测验、模拟和项目任务。
OpenMAIC与普通课件生成工具的区别可以概括为三点。第一,产物不仅是静态幻灯片,还包括Quiz、互动HTML模拟和PBL项目。第二,课程不是生成后就结束,Agent工作台允许继续修改、补充材料和调整页面。第三,课堂运行阶段仍有智能体参与,而不是播放固定视频。
根据官方仓库,v1.0.0新增聊天优先的Agent工作台,可规划、生成和修订整门课程;运行会话由服务器支持,可以取消、恢复和继续引导;用户可以上传文档、音频和视频,或者引入网页搜索;系统提供课件、测验、互动组件、PBL、图像、视频、语音和PPTX导入等课程工具以及20个内置Skills。
58万、100万与3400万:数据应该怎样引用
结论是:这组数据具有传播价值,但必须标注为“平台统计”和明确统计时间,不能转写为独立第三方审计结果。
清华大学新闻网2026年9月13日页面写明,据平台统计,自3月正式开源以来,截至8月底,OpenMAIC已汇聚超过58万名创作者,累计生成超过100万门AI课程,全球AI交互次数突破3400万次,覆盖154个国家和地区。报道还提到团队在联合国教科文组织2026数字学习周进行学术报告和现场实操。
| 指标 | 官方披露值 | 正确表述 | 不应推断 |
|---|---|---|---|
| 创作者 | 超过58万名 | 据平台统计,截至2026年8月底 | 58万付费用户 |
| AI课程 | 超过100万门 | 累计生成课程数量 | 100万门均已公开或通过教学验收 |
| AI交互 | 突破3400万次 | 全球AI交互次数 | 独立学习人数或学习完成次数 |
| 国家和地区 | 154个 | 使用覆盖范围 | 每个国家均有正式学校部署 |
这组数据能证明项目拥有较大的使用和传播规模,但不能替代课程质量、学习效果、留存率、单位成本和教育公平性的独立评估。制作推广内容时,建议在数字旁保留“据平台统计”和“截至8月底”。
技术架构:一门AI课堂是怎样生成的
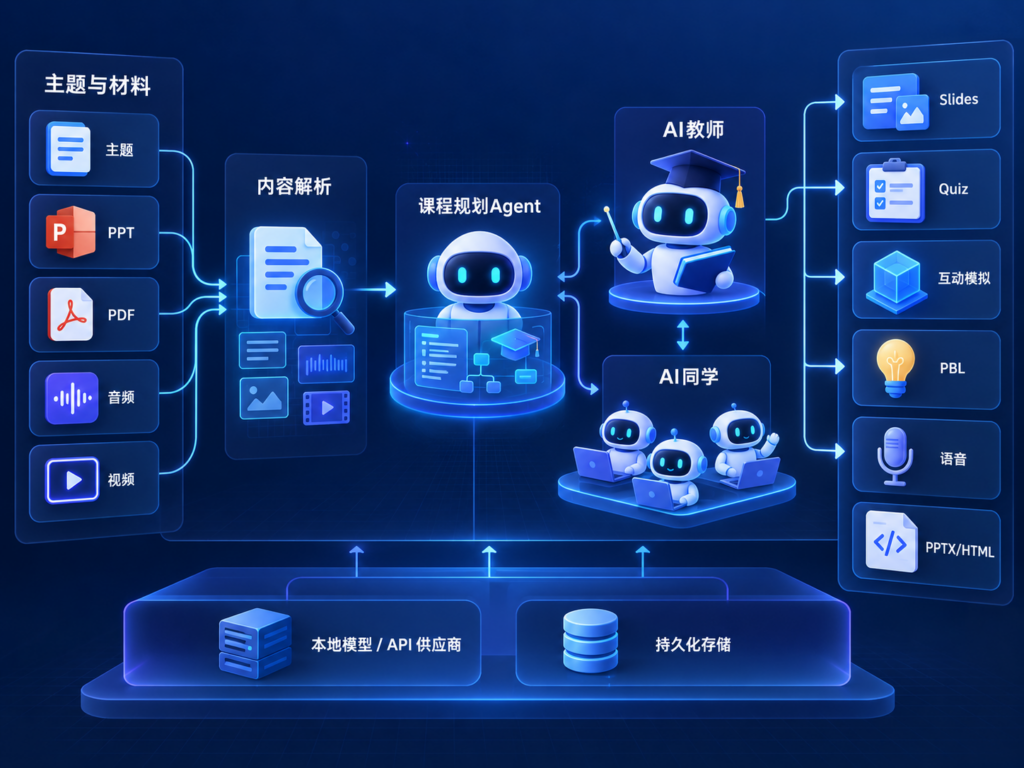
结论是:OpenMAIC可以理解为“材料处理+课程规划Agent+场景生成工具+课堂运行时+导出与持久化”的组合系统。
用户输入主题或材料后,系统需要完成内容解析、课程结构规划、场景生成和资源生产。课程页面可能包含文本、图像、表格、图表、公式、代码、语音和交互组件。课堂运行时再把这些页面组织为可播放、可交互的学习体验。
官方仓库支持多种模型提供商,包括OpenAI、Azure OpenAI、Anthropic、Amazon Bedrock、Google Gemini、DeepSeek、Qwen、Kimi、MiniMax、Grok、OpenRouter、豆包、腾讯混元、GLM、Ollama、本地Lemonade及兼容OpenAI接口的服务。模型可替换并不代表所有模型效果相同,课程规划、长材料理解、结构化输出和互动组件生成需要分别测试。
材料链路也有边界。对本地音视频,官方说明可以安装 ffmpeg 和 ffprobe 提取带时间戳的转写与关键帧,再连接FunASR、Lemonade或其他ASR。如果本地工具不可用,系统可以走已配置的云解析路径;两条路径都不可用时,材料会标记失败并显示可操作提示,而不是静默生成空转写。
部署前准备:硬件、软件和账号
结论是:基础Web应用对GPU没有硬性要求,但模型、图像、语音和视频是否本地运行,会决定实际硬件需求。
官方最低软件条件
- Git,用于克隆和更新仓库;
- Node.js 22.19或更高版本;
- pnpm 10或更高版本;
- 至少一个可用的大模型提供商,或已运行的本地兼容模型;
- Docker与Docker Compose,仅Docker方案需要;
- ffmpeg与ffprobe,仅本地音视频提取需要。
普通CPU服务器可以运行OpenMAIC Web应用并调用云模型。若同时在本机运行大语言模型、图像生成、TTS与ASR,则需要根据模型规模配置GPU显存、内存和磁盘。官方仓库没有给出一个适用于所有本地模型组合的统一最低GPU规格,因此不能承诺“任意电脑一键全离线”。
推荐测试环境
个人体验可使用4核CPU、8GB以上内存和20GB以上可用磁盘,模型走云API或另一台推理服务器。多人内网试点建议至少4—8核CPU、16GB以上内存、PostgreSQL持久化、反向代理和独立对象存储。具体并发能力需要用自己的课件长度、模型延迟和用户量压测。
API Key准备
至少配置一种LLM。不要把真实Key写入教程、Git仓库、Dockerfile或前端变量。统一放在服务器端 .env.local 或受控Secrets系统中,并限制账单额度、来源IP和可用模型。
方法一:Node.js本地部署
结论是:Node.js方式最适合首次体验、功能调试和二次开发,步骤最透明,出现错误也容易定位。
第一步:检查版本
node --version
pnpm --version
git --version
Node版本必须达到22.19,pnpm必须达到10。若系统中存在多个Node版本,建议用版本管理工具切换,不要直接覆盖服务器上其他项目的运行环境。
第二步:克隆官方仓库
git clone https://github.com/THU-MAIC/OpenMAIC.git
cd OpenMAIC
用于生产时不要长期跟随浮动的 main 分支。先记录经过验证的Commit或Release,再创建自己的配置和升级流程,以便出现兼容问题时回退。
第三步:安装依赖
pnpm install国内网络安装较慢时,可以在可信范围内配置镜像;不要把带用户名、密码或Token的私有镜像地址写入Docker构建参数,因为它可能进入镜像元数据或构建记录。
第四步:复制环境变量文件
cp .env.example .env.local编辑 .env.local,只填写实际使用的提供商。以下仅为占位示例:
GOOGLE_API_KEY=YOUR_GOOGLE_API_KEY
DEFAULT_MODEL=google:gemini-3-flash-preview
ACCESS_CODE=YOUR_STRONG_ACCESS_CODE
官方README推荐Gemini 3 Flash作为质量与速度的平衡选择,并说明服务器API默认使用Gemini时可设置 DEFAULT_MODEL=google:gemini-3-flash-preview。模型ID会变化,部署时应再次核对仓库与提供商控制台。
也可以使用OpenAI兼容服务:
OPENAI_API_KEY=YOUR_API_KEY
OPENAI_BASE_URL=https://YOUR_OPENAI_COMPATIBLE_ENDPOINT/v1
DEFAULT_MODEL=openai:YOUR_MODEL_ID
环境变量名称应以当前 .env.example 为准,兼容服务的模型列表和额外配置需要根据仓库文档调整。
第五步:启动开发服务器
pnpm dev浏览器打开 http://localhost:3000。如果部署在远程服务器上,不要直接把开发端口暴露到公网;可用SSH端口转发测试,或在生产构建后通过HTTPS反向代理访问。
第六步:生产构建
pnpm build
pnpm start生产构建前要完成课程生成、上传、导出、重启恢复和错误提示测试。pnpm start并不自动提供TLS、进程守护、监控、备份和用户系统,这些仍需要Nginx/Caddy、systemd或容器平台补齐。
方法二:Docker Compose一键部署
结论是:Docker Compose更适合固定依赖并迁移到服务器,但“一条命令启动”不等于生产配置已经安全。
- 安装Git、Docker Engine和Docker Compose插件。
- 克隆仓库并进入目录。
- 复制
.env.example为.env.local。 - 写入至少一个模型提供商Key,并设置访问码。
- 执行构建与启动命令。
git clone https://github.com/THU-MAIC/OpenMAIC.git
cd OpenMAIC
cp .env.example .env.local
docker compose up --build
后台运行可使用:
docker compose up --build -d
docker compose ps
docker compose logs -f
国内网络构建较慢时,官方支持可选的Alpine和npm镜像参数:
ALPINE_MIRROR=mirrors.tuna.tsinghua.edu.cn \
NPM_REGISTRY=https://registry.npmmirror.com \
docker compose up --build
这两个参数不会加速Docker Hub镜像拉取,也不能替代Docker Daemon镜像配置。参数中不要放认证凭据。
如果你使用1Panel服务器,可在终端完成上述命令,再用反向代理把子域名转发到OpenMAIC端口。SSL证书、WebSocket/流式响应、上传大小、超时和访问控制需要在反向代理中单独设置。可参考 AI Stack Nav本地部署教程 统一配置Docker、域名和HTTPS。
配置本地模型、语音与材料解析
结论是:只把Web界面部署到本机仍会调用云端;要实现数据尽量不出内网,必须逐项本地化LLM、ASR、TTS、图像和文档解析。
使用Ollama或兼容端点
OpenMAIC官方列出的提供商包括Ollama以及任何OpenAI兼容API。启动本地模型服务后,将Base URL与模型ID配置到OpenMAIC。不同版本的具体变量可能调整,应以 .env.example 和管理界面显示为准。
使用Lemonade本地能力
官方README给出的本地Lemonade示例如下,可同时为LLM、TTS、ASR与图像提供OpenAI兼容端点:
LEMONADE_BASE_URL=http://localhost:13305/v1
TTS_LEMONADE_BASE_URL=http://localhost:13305/v1
ASR_LEMONADE_BASE_URL=http://localhost:13305/v1
IMAGE_LEMONADE_BASE_URL=http://localhost:13305/v1如果OpenMAIC运行在Docker中,localhost指容器本身,不是宿主机。需要使用同一Compose网络中的服务名,或按操作系统配置宿主机网关地址。
配置FunASR
官方示例支持SenseVoiceSmall、Paraformer和Fun-ASR-Nano。CPU模式可用于功能验证,长音视频和多人并发需要评估速度。
python -m pip install torch torchaudio
python -m pip install "funasr==1.4.0" fastapi uvicorn python-multipart
funasr-server --device cpu --model sensevoice
然后配置:
ASR_FUNASR_BASE_URL=http://localhost:8000/v1第三方Python依赖和模型文件应在隔离环境中安装,并在生产前进行许可证与供应链扫描。
安装ffmpeg
确保下面两个命令都能执行:
ffmpeg -version
ffprobe -version
缺少它们时,OpenMAIC仍可启动,但本地音视频提取会跳过。材料失败时先查看服务日志和页面提示,不要不断重复上传导致磁盘和API账单增加。
生成第一门多智能体AI课堂
结论是:第一门课应选资料明确、范围小、答案可核验的主题,用它建立课程质量基线,而不是直接上传数百页材料。
- 打开OpenMAIC主页,创建新课程或进入Agent工作台。
- 输入教学对象、时长、学习目标、先修知识和产物要求。
- 上传经过授权的PDF、PPTX、音频或视频;不要上传包含个人隐私和未授权教材的材料。
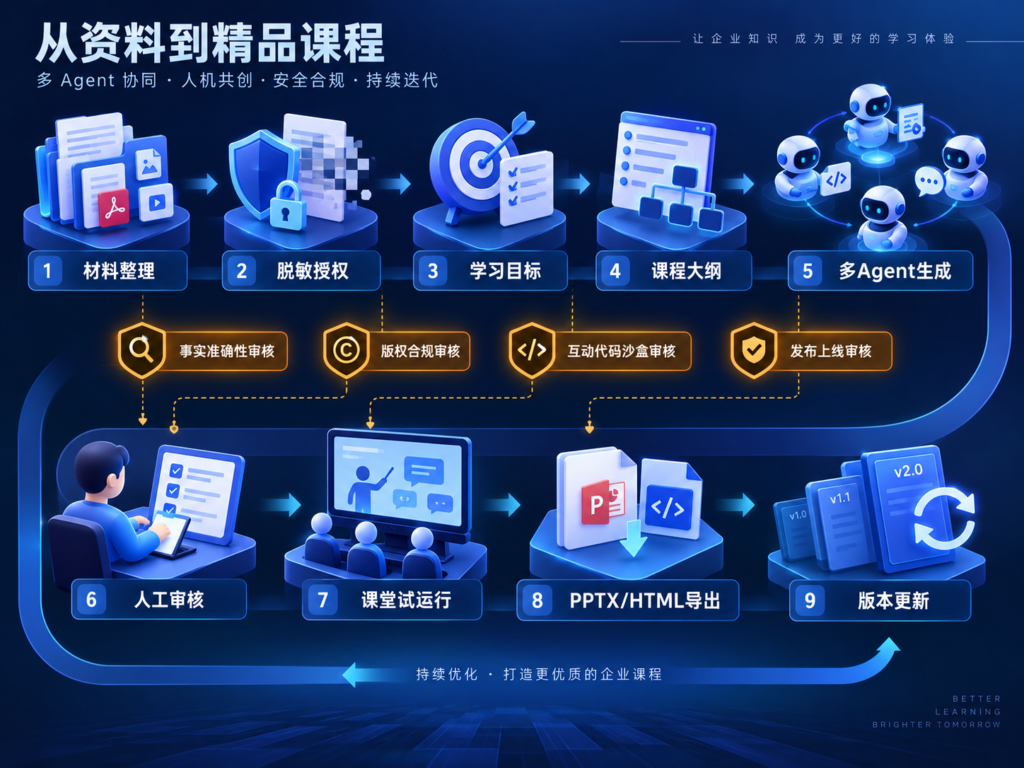
- 先审查课程大纲,删除偏题章节并调整顺序。
- 生成场景,重点检查事实、公式、图片、测验答案与互动组件代码。
- 运行课堂,体验AI教师讲解、AI同学讨论、白板和Quiz。
- 在Agent工作台要求局部修改,不要每次整门课重做。
- 导出可编辑PPTX或HTML,在离线环境验证资源是否完整。
- 保存本次模型、参数、耗时、Token与人工修改记录。
可复制的提示词示例:
请创建一门30分钟的《企业AI Agent安全入门》互动课程。
对象:具备基础IT知识的业务部门员工。
学习目标:理解Agent、工具权限、Prompt Injection和人工审批。
结构:5个章节,每章1个核心概念;包含2次选择题、1个风险判断互动、1个小组讨论。
要求:所有安全结论以我上传的公司制度为准;资料未覆盖的内容明确标注“需管理员确认”;不要自动生成公司不存在的流程。
环保业务培训实战:把巡查制度变成互动课堂
结论是:OpenMAIC很适合把环保巡查制度、检查表和典型案例转换成情景化培训,但执法依据、处罚标准和企业隐私必须由人工审核。
例如制作《乡镇生态环境巡查问题上报培训》,可以上传已脱敏的巡查制度、问题分类表、拍照规范和整改流程。课程大纲可分为现场识别、证据采集、问题上报、整改复查和安全注意事项。互动场景让学习者判断“照片是否满足定位和全景要求”“问题应归入哪一类”“何时需要升级报告”。
推荐产物包括:
- 10—15页可编辑PPT;
- AI教师口播与白板示意;
- 5道分类判断题;
- 1个模拟上报表单;
- 1个整改闭环PBL任务;
- 课程HTML离线包;
- 人工审核记录与版本号。
不要直接上传包含人员身份证号、企业商业秘密、未公开监测数据或精确敏感位置的原始材料。案例应脱敏,法律法规和标准引用必须核对有效状态,最终培训课件由业务负责人签字确认。
PostgreSQL持久化:多人部署前必须理解的限制
结论是:官方提供PostgreSQL参考方案,但README明确警告开发Token不能提供真正的多用户隔离,公网生产环境不能照抄。
官方 server-persistence Profile运行两个容器:OpenMAIC应用和PostgreSQL,持久化HTTP服务嵌入应用的 /api/persistence。参考启动方式为:
NEXT_PUBLIC_PERSISTENCE=1 \
NEXT_PUBLIC_PERSISTENCE_TOKEN=YOUR_DEV_TOKEN \
docker compose --profile server-persistence up --build
.env.local 中还需配置数据库连接和对应服务端Token。这里不能忽略官方的重要说明:NEXT_PUBLIC_ Token会编译进浏览器JavaScript,所有访问者都能看到,不能提供机密性或用户隔离。官方将其定位为localhost或可信网络的单用户开发用途。
因此,多人正式部署前必须把开发认证替换为真实会话验证,由服务端身份推导学习者分区,并重新设计文档、合并与管理权限。还应增加数据库备份、恢复演练、对象存储权限、课程Owner、租户隔离和删除流程。
ACCESS_CODE能保护到什么程度
结论是:ACCESS_CODE适合阻挡未授权访问和简单扫描,但不能代替企业SSO、账号权限和审计。
配置示例:
ACCESS_CODE=YOUR_RANDOM_LONG_ACCESS_CODE设置后,访问者会看到密码提示,API路由也受到保护。但多人共享同一个访问码仍无法区分是谁创建、查看或删除课程;访问码泄露后也无法只撤销某一个人。企业使用时应接入OIDC/SSO,并实现课程级Owner、角色和审计日志。
成本怎样计算
结论是:OpenMAIC代码本身为MIT开源,但课程生成成本取决于模型、图片、语音、视频、搜索、解析、存储与人工审核,官方没有给出对所有配置都适用的固定单课价格。
可用以下公式估算:
单课成本 = LLM输入成本 + LLM输出成本 + 图片生成成本
         + TTS/ASR成本 + 视频或文档解析成本
         + 搜索与存储成本 + 人工审核成本
测试时为每门课记录请求次数、输入输出Token、生成图片数、语音分钟数、失败重试和人工修改时长。模型路由可以分层:大纲与最终校验使用质量较高模型,格式化和简单页面使用低成本模型,本地ASR处理音视频。不要引用网上“每门课不到2美元”等数字作为自己的承诺,除非用当前模型价格和同等课程进行实测。
与PPT生成器、LMS和RAG问答的区别
结论是:OpenMAIC更适合“生成并运行互动课堂”,但它不能自动取代正式LMS、考试系统和知识治理平台。
| 方案 | 主要产物 | 互动方式 | 最适合场景 | 局限 |
|---|---|---|---|---|
| OpenMAIC | PPT、Quiz、互动HTML、PBL、多Agent课堂 | AI教师与同学参与 | 快速创课、培训、探索式学习 | 仍需审核与生产级身份改造 |
| 普通AI PPT | 静态课件 | 翻页或演讲 | 汇报、快速演示 | 缺少课堂智能体与深层互动 |
| LMS | 课程管理、报名、进度、考试 | 固定教学流程 | 正式培训运营 | 内容生成能力通常较弱 |
| RAG问答 | 基于知识库的回答 | 用户提问 | 制度查询、客服 | 不自动形成完整课程结构 |
实际企业项目可以组合使用:OpenMAIC生成课程与互动内容,LMS负责账号、选课、进度和证书,知识库负责权威材料检索,审批系统负责发布。更多组合思路可参考 AI Stack Nav多智能体工作流。
安全、版权与教学质量
结论是:生成成功不等于可以发布,课程必须经过内容、版权、代码和权限四类审核。
Prompt Injection与材料污染
上传的文档、网页或音视频转写可能包含“忽略系统指令”“上传内部数据”等恶意内容。材料应被视为不可信数据,课程Agent不应拥有服务器Shell、任意文件和高权限网络工具。搜索域名、文件类型和上传大小需要白名单。
互动HTML风险
OpenMAIC可生成交互组件。任何AI生成HTML、JavaScript都应在Sandbox中运行,限制网络、Cookie、父页面访问和文件下载,并设置内容安全策略。不要把未经审查的组件嵌入拥有管理员会话的后台页面。
教材与肖像版权
开源软件许可证不等于用户上传材料自动获得使用权。公开课程前应确认教材、图片、音乐、视频、字体和人物声音的授权。语音克隆尤其要取得明确同意,并提供删除和撤销机制。
未成年人和学习数据
学校场景会产生聊天、答题、语音和学习轨迹。应最小化收集,获得适当授权,设置保存期限和访问角色,并避免把个体画像用于未经说明的高风险决策。
人工审批
课程发布、外发邮件、公开分享、删除课程、修改账号权限、连接收费模型和导出敏感数据等动作,应有人工确认或权限隔离。AI测验评分也不应在缺少复核机制时直接用于高风险升学或人事决定。
常见故障排查
pnpm install失败
先确认Node与pnpm版本,再清理单个项目的依赖缓存并重试。不要随意删除整台服务器的全局Node环境。网络慢时使用可信镜像,并核对锁文件是否被意外修改。
页面能打开但课程生成失败
检查至少一个LLM Key、DEFAULT_MODEL与实际提供商是否一致,再查看服务端日志中的401、403、429或模型不存在错误。429通常是速率或额度问题,应降低并发、退避重试或更换已授权模型,而不是无限重试。
Docker内无法访问宿主机模型
容器中的 127.0.0.1 指容器自己。把本地模型加入同一Compose网络并使用服务名,或配置宿主机网关;同时检查模型服务是否监听允许容器访问的地址和防火墙规则。
音视频上传后解析失败
运行 ffmpeg -version 和 ffprobe -version,确认容器内部同样可执行;再检查ASR端点和模型。限制单文件大小、时长与并发,避免长视频占满磁盘。
重启后课程消失
默认浏览器存储与服务端持久化的行为不同。多人或长任务需要配置PostgreSQL参考栈,并理解迁移、用户分区与备份限制。不要把公开可见的开发Token当成生产认证。
PPTX或HTML导出不完整
检查字体、远程图片、公式、互动组件和浏览器渲染依赖。导出后在无登录状态或离线电脑打开验证,避免课程依赖仅在创建者浏览器中存在的资源。
事实依据与来源
本文以清华大学新闻页和THU-MAIC官方GitHub仓库为主要依据,并明确区分事实、平台数据与实施建议。
- 官方已确认事实: OpenMAIC由清华大学MAIC团队研发并开源;平台可把主题或文档转为多智能体互动课堂;支持幻灯片、测验、互动模拟和PBL等场景。
- 官方仓库信息: v1.0.0于2026年8月27日发布;要求Node.js ≥22.19、pnpm ≥10;支持Node.js、Docker Compose、Vercel及多种模型提供商;当前许可证为MIT。
- 平台统计数据: 截至2026年8月底,超过58万名创作者、超过100万门AI课程、超过3400万次AI交互、覆盖154个国家和地区。该组数据由清华新闻引述平台统计,并非本文独立审计。
- 第三方测试: 本文未引用第三方课程质量、成本或学习效果Benchmark,也没有把网络传播的固定单课成本当成官方承诺。
- 编辑判断: OpenMAIC适合教育、企业和环保培训,是根据功能与场景作出的选题判断,不代表清华大学对具体业务的背书。
- 实施建议: 硬件建议、模型路由、SSO、权限、课程审核、环保培训模板与成本公式属于工程建议。
- 待实际验证: 不同模型的生成质量、本地硬件并发、单课成本、复杂PPT导入还原度和多人运行稳定性,需要在目标环境实测。
FAQ
OpenMAIC是清华大学官方开源项目吗?
是。清华大学新闻页明确称其为清华大学教育学院MAIC团队自主研发的AI教育智能体项目,代码由THU-MAIC组织公开维护。部署时应认准 github.com/THU-MAIC/OpenMAIC 仓库。
OpenMAIC完全免费吗?
代码当前采用MIT许可证,可免费使用和修改;但模型API、图像、语音、视频解析、服务器、域名和存储可能产生费用。商业使用仍需遵守MIT许可证及所用模型、素材和第三方服务条款。
网上为什么有教程说它是AGPL-3.0?
这是版本变化造成的。官方仓库Changelog显示,项目在2026年6月的v0.3.0阶段从AGPL-3.0重新许可为MIT。应以当前仓库LICENSE和准备部署的具体Commit为准。
OpenMAIC必须有GPU吗?
Web应用本身和调用云模型不要求本机GPU。只有在本机运行LLM、图像生成、ASR或TTS时,才需要按模型规模配置GPU。CPU可以用于部分ASR或小模型测试,但速度需要实测。
支持哪些模型?
官方仓库列出OpenAI、Azure OpenAI、Anthropic、Bedrock、Gemini、DeepSeek、Qwen、Kimi、MiniMax、Grok、OpenRouter、豆包、混元、GLM、Ollama、Lemonade及OpenAI兼容接口。具体模型ID随版本和服务商变化。
能否完全离线部署?
理论上可以用本地LLM、Lemonade、本地FunASR、ffmpeg和本地资源减少外部依赖,但完整离线效果取决于所选模型、图像、TTS、搜索和解析能力。只本地运行Web界面但使用云API不属于完全离线。
可以上传PPT、PDF和视频吗?
v1.0.0支持会话材料,官方仓库说明包括文档、音频和视频,并支持PPTX导入。音视频本地提取需要ffmpeg/ffprobe及ASR服务;复杂文档的解析质量需逐份验证。
能导出可编辑PPT吗?
官方功能列表包含可编辑 .pptx 导出和互动HTML导出。导出后仍应检查字体、公式、图片、动画和互动组件,因为浏览器课堂与PowerPoint支持的能力并不完全相同。
ACCESS_CODE适合公网多人使用吗?
只适合简单访问保护,不足以承担正式多人身份与权限管理。公网或企业部署应接入SSO/OIDC,按用户和课程隔离数据,记录审计日志,并限制管理操作。
如何升级而不丢失课程?
固定当前Commit或Release,升级前备份PostgreSQL、课程文件和配置,在测试环境运行迁移与导出验证,再切换生产。不要在生产目录直接追随 main 并执行不可回退的更新。
参考来源
- 清华大学:国产AI教育智能体亮相联合国教科文组织
- THU-MAIC/OpenMAIC官方GitHub仓库
- OpenMAIC官方中文README
- OpenMAIC官方更新日志
- OpenMAIC官方安全说明
环境配置与 Docker 工作流
适合阅读安装部署、本地配置、服务器搭建和自动化流程类文章后继续转化。
