发布: · 最后更新:
摘要: Anthropic 于 2026 年 11 月 9 日发布 Claude Fable 5.2 和 Claude Mythos 5.2。本文讲清这次更新改了什么:API 价格比 Fable 5.1 降 20%(输入 8 美元、输出 40 美元/百万 Token),输出速度最多快 30%,编程、电脑操作、知识工作等基准大幅提升,误拦截减少约 55%。同时说明 Claude 各订阅档位怎么用、API 迁移有哪些会报错的改动、成本怎么算。结论是:做长时间编程 Agent、复杂研究和电脑操作任务的开发者值得尽快测试;日常写作和一般编码,Anthropic 官方仍推荐 Opus 5.5。读完你能判断要不要切换、怎么改代码、怎么控制费用。
核心结论
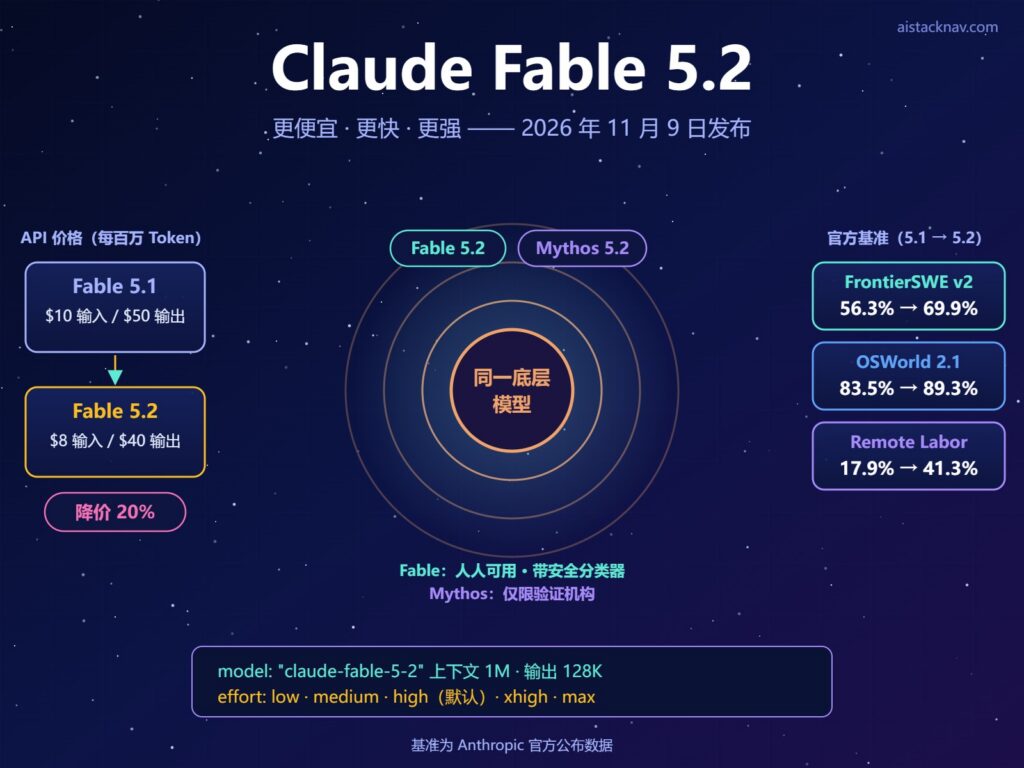
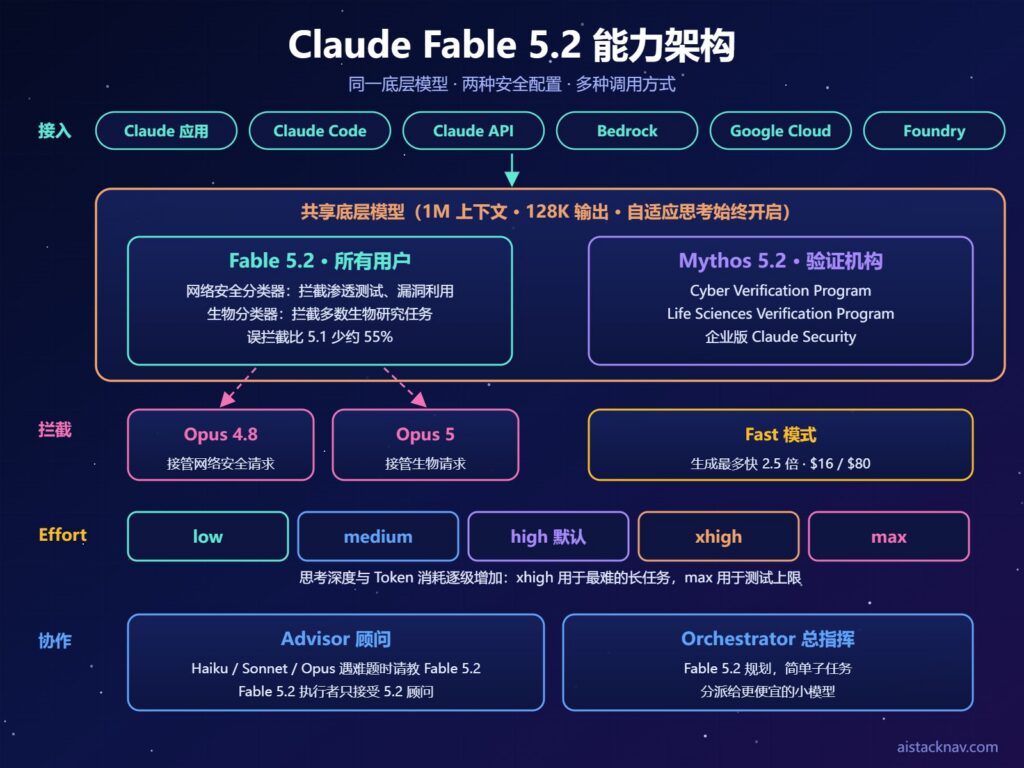
Claude Fable 5.2 是 Anthropic 目前对所有用户开放的最强模型,2026 年 11 月 9 日上线,模型 ID 为 claude-fable-5-2。它和 Mythos 5.2 是同一个底层模型,区别只在于 Fable 加了网络安全和生物领域的安全分类器,所以人人可用;Mythos 5.2 去掉了部分限制,只开放给通过验证计划的机构。对大多数开发者来说,这次更新的意义是“更强、更快、更便宜”同时发生。
- 价格下降 20%: API 标准价从 Fable 5.1 的输入 10 美元 / 输出 50 美元降到 8 美元 / 40 美元(每百万 Token);Batch 为 4 / 20 美元;新增 Fast 模式,价格翻倍、生成速度最多 2.5 倍。
- 速度与能力: 官方称各档 effort 下输出最多快 30%;FrontierSWE v2 从 56.3% 升到 69.9%,OSWorld 2.1 从 83.5% 升到 89.3%,Remote Labor Index 从 17.9% 升到 41.3%(以上为 Anthropic 官方公布数据)。
- 订阅可用性: Free 不可用;Pro 和 Team 标准席位通过“用量额度(usage credits)”按 API 价付费;Max、Ultra、Team 高级席位最多可把每周限额的 50% 用在 Fable 上。上线首周有限时福利。
- API 有 4 个破坏性改动: 思维块校验对所有账号生效、思维块只能被 5.2 读取、旧版
computer_20251124工具被拒绝、Advisor 必须换成 5.2。直接把模型 ID 从 5.1 改成 5.2,部分代码会收到 400 错误。 - 适合谁: 长时间编程 Agent、电脑操作自动化、科研与复杂分析。官方原话是 Opus 5.5 仍是“最强的日常主力”,Fable 和 Mythos 用于最有野心的工作。
背景与主要变化
Fable 系列从 2026 年 6 月的 Fable 5 开始,定位一直是“比 Opus 更高一档”的前沿模型。6 月 Fable 5 和 Mythos 5 曾因美国商务部出口管制被暂停访问,7 月 1 日恢复;9 月推出 Fable 5.1。这次 5.2 是两个月内的第二次迭代,核心变化是价格、速度、能力和误拦截率同时改善。
下表把官方文档与公告中的关键参数整理在一起(均为 2026 年 11 月 9 日官方数据):
| 项目 | Claude Fable 5.1 | Claude Fable 5.2 |
|---|---|---|
| 模型 ID | claude-fable-5-1 | claude-fable-5-2 |
| 输入价格(每百万 Token) | 10 美元 | 8 美元 |
| 输出价格(每百万 Token) | 50 美元 | 40 美元 |
| 缓存读取 | 基础输入价 × 0.025 | 0.20 美元 |
| Batch API | — | 输入 4 美元 / 输出 20 美元 |
| Fast 模式 | — | 输入 16 美元 / 输出 80 美元,生成最多快 2.5 倍 |
| 上下文窗口 / 最大输出 | — | 100 万 Token / 12.8 万 Token |
| 思考模式 | — | 自适应思考,始终开启,不能关闭 |
| Effort 档位 | — | low / medium / high / xhigh / max,API 默认 high |
| 知识截止 | — | 2026 年 6 月 |
| 数据保留 | — | 30 天(零数据保留需 Anthropic 特别授权) |
几点值得注意的背景:
- 同一模型,两种安全配置。 Fable 5.2 会拦截高风险的网络安全任务(如渗透测试、漏洞利用生成、二进制漏洞研究)和大部分生物研究任务,被拦截的请求会自动路由到 Opus 4.8(网络安全)或 Opus 5(生物)。官方称相比 5.1,总体误拦截减少约 55%,其中网络安全减少约 60%、生物减少约 40%。
- Mythos 5.2 扩大开放。 网络安全从业者可申请 Cyber Verification Program,生命科学研究者可申请 Life Sciences Verification Program,企业客户可通过 Claude Security 使用 Mythos 5.2。
- 企业零数据保留的新路径。 新的 Enterprise Frontier Safeguards(EFS)处于私有测试(private beta)阶段,把安全监控放到客户自己的基础设施里运行,可以与零数据保留兼容。本站此前的 Fable 5.1 数据保留与 EFS 解读 可作为背景参考。
核心功能拆解
Fable 5.2 的提升不只是“分数更高”,而是在 Agent 工作流的几个关键环节都有新机制:Effort 控制思考深度、Advisor/Orchestrator 让大小模型分工、Fast 模式换速度、保留思维(Preserved thinking)保证长对话推理连贯。
1. 编程与 Agent 能力。 官方公布的 FrontierSWE v2(Agent 编程)成绩为 69.9%,高于 Fable 5.1 的 56.3%、Opus 5.5 的 62.3% 和 GPT-6 Astra 的 65.5%。在 FrontierCode 2.0 上,Fable 5.2 在 High 档的得分(45.3%)与 Opus 5.5(45.5%)基本持平,但官方称每个任务成本约为一半。Anthropic 还透露,公司核心代码库中超过 90% 的合并改动由 Claude 编写(有人工指导)。
2. 电脑操作与机器人。 OSWorld 2.1(离线部分得分)达到 89.3%;RoboDojo 机器人控制模拟从 27.6% 跃升到 64.9%。电脑操作工具换成了新的 computer_toolset_20260801。
3. 知识工作与科研。 Remote Labor Index 从 17.9% 升到 41.3%(High 档),Humanity’s Last Exam(带工具)从 65.6% 升到 74.2%。官方案例包括:用 1000 个 Fable 5.2 Agent 在 30 小时内完成费马大定理证明的形式化(同样配置下 Opus 5.5 在 18 小时内只完成 26%),以及解决两个黑洞物理开放问题。这些属于官方展示案例,尚无独立复现。
4. 视觉与图表理解。 Chartography(无工具)从 44.8% 提升到 73.4%,在 Medium 档就达到 66.4%,超过 Opus 5.5 在 Max 档的 64.4%。
5. Effort 五档。 low、medium、high、xhigh、max。API 默认 high,Claude 应用和 Claude Code 默认 medium。官方建议 xhigh 用于最难的长时间编程与 Agent 任务,max 只用于测试模型上限。注意:在 high 及以上,模型几乎每次回复前都会思考;提示词里写“少想一点”在 medium 以上不起作用,要省 Token 应直接降低 effort。
6. Advisor 与 Orchestrator。 Haiku、Sonnet 或 Opus 可以把 Fable 5.2 当作“顾问”,遇到难题时请教它;反过来,Fable 5.2 也可以当“总指挥”,把简单子任务分派给更小、更便宜的模型。这是控制成本的重要手段。Fable 5.2 作为顾问时返回的建议是加密的。
7. Fast 模式。 生成速度最多快 2.5 倍,价格翻倍。支持 Claude API、Claude Code、Google Cloud 上的 Claude 模型和 Microsoft Foundry(在 Foundry 上是单独的模型 claude-fable-5-2-fast)。
8. 新 Beta 能力。 按需上下文压缩(Compaction on demand)、对话中途修改工具列表、服务端拒答回退(fallbacks)等,适合构建长时间运行的 Agent。
适用人群与使用场景
结论:Fable 5.2 值得用在“任务长、步骤多、出错代价高”的场景;短问答和日常写作用它是浪费。
推荐优先测试的人:
- 做 Coding Agent 的开发者: 多文件重构、跨仓库迁移、长时间无人值守修 Bug。xhigh 档配合按需压缩,适合跑数小时的任务。可以参考本站的 Fable 5.1 API 缓存与 Agent 成本教程,方法同样适用于 5.2,只需替换价格。
- 电脑操作自动化团队: 网页操作、表单处理、跨应用流程,OSWorld 成绩提升明显。
- 科研与数据分析人员: 数学形式化、物理推导、读图表、长文献综述。
- 企业知识工作: 报告撰写、财务模型、合规审查等 Remote Labor Index 类任务。
不必急着换的人:
- 日常聊天、写文章、翻译:Sonnet 5.5 或 Opus 5.5 已经足够,而且更快、更省额度。
- 预算敏感的高并发服务:Fable 5.2 延迟为“中等”,Sonnet 5.5 为“快”、Haiku 5.5 为“最快”。
- 需要
temperature等采样参数或强制工具调用的旧系统:Fable 5.2 不支持,需要先改代码。 - 只用免费版的用户:Free 计划不能使用 Fable。
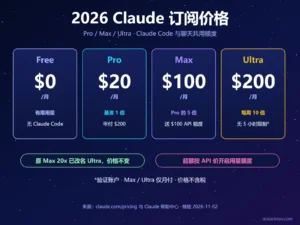
订阅用户怎么用(2026 年 11 月 9 日核对 claude.com/pricing 与官方支持中心):
| 计划 | 月费 | Fable 5.2 使用方式 | 上线福利 |
|---|---|---|---|
| Free | 0 美元 | 不可用 | 无 |
| Pro | 20 美元(年付折合 17 美元) | 用量额度,按 API 价计费 | 11 月 9~16 日纳入套餐,最多占每周限额 50%,外加 1 次 Fable 限额重置 |
| Max | 100 美元 | 已包含,最多占每周限额 50% | 1~3 次 Fable 限额重置(按订阅时长),2027 年 3 月 8 日前有效 |
| Ultra | 200 美元 | 已包含,最多占每周限额 50% | 同 Max |
| Team 标准席位 | 按席位 | 用量额度 | 同 Pro |
| Team 高级席位 | 按席位 | 已包含,最多占每周限额 50% | 同 Max |
| Enterprise | 按合同 | 需管理员开启 | 仅部分席位型方案 |
需要强调的是,“50% 上限”不是额外赠送的额度,而是 Fable 最多能占用你每周总限额的一半,其他模型共用同一个池子。订阅价格的详细对比见本站 Claude Pro、Max、Ultra 怎么选。
安装、配置或使用步骤
下面按“应用内使用”和“API 迁移”两条路线说明。API 迁移是本次的重点,因为有 4 个会直接报错的改动。
- 在 Claude 应用中选择模型。 网页版、桌面版、手机版在模型选择器中选“Fable 5.2”。Enterprise 用户如果看不到,需要管理员先开启;官方称上线 7 天后会自动加入已启用 Fable 的角色。
- 在 Claude Code 中使用。 升级到 2.1.321 或更高版本,然后切换模型。Claude Code 默认 medium 档,复杂重构可以手动调到 xhigh。
- API:替换模型 ID。 把
claude-fable-5-1改为claude-fable-5-2。Bedrock 上为anthropic.claude-fable-5-2。 - API:删掉不支持的参数。 去掉
temperature、top_p、top_k;去掉thinking: {"type": "enabled", "budget_tokens": ...}或{"type": "disabled"},改为不传或传{"type": "adaptive"};tool_choice不能用any或指定工具,改用auto加strict: true,或者用 JSON 输出。 - API:检查对话历史处理。 如果你的代码会编辑历史消息、在不同模型之间切换,或者把一个账号的对话转给另一个账号,思维块会失效或被丢弃。最稳妥的做法是:固定
system和tools,只追加messages,每个助手回复原样回传。 - API:更新电脑操作工具。 把
computer_20251124换成computer_toolset_20260801(Amazon Bedrock 除外)。 - API:更新 Advisor。 如果你用 Fable 5.2 当执行者,顾问模型必须是
claude-fable-5-2或claude-mythos-5-2,否则返回 400。 - 重跑评测。 官方建议从默认 high 档开始做一次 effort 扫描(low 到 xhigh),对比质量、Token 消耗和耗时,再决定生产环境用哪一档。
最小可运行的 Python 调用示例(参数写法以官方 SDK 文档为准):
import os
import anthropic

client = anthropic.Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])  # 环境变量里放 YOUR_API_KEY

response = client.messages.create(
    model="claude-fable-5-2",
    max_tokens=8000,
    # 不要传 temperature / top_p / top_k,也不要关闭思考
    output_config={"effort": "medium"},   # low / medium / high / xhigh / max
    messages=[
        {"role": "user", "content": "阅读这份需求文档,列出实现步骤和风险点。"}
    ],
)

if response.stop_reason == "refusal":
    print("请求被安全分类器拦截,可改用 Opus 模型或调整任务描述")
else:
    print(response.content[-1].text)
如果你在用 curl 测试,同样只需改模型名:
curl https://api.anthropic.com/v1/messages \
  -H "x-api-key: YOUR_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 4000,
    "messages": [{"role": "user", "content": "用三句话总结这段日志的错误原因"}]
  }'
实际工作流示例
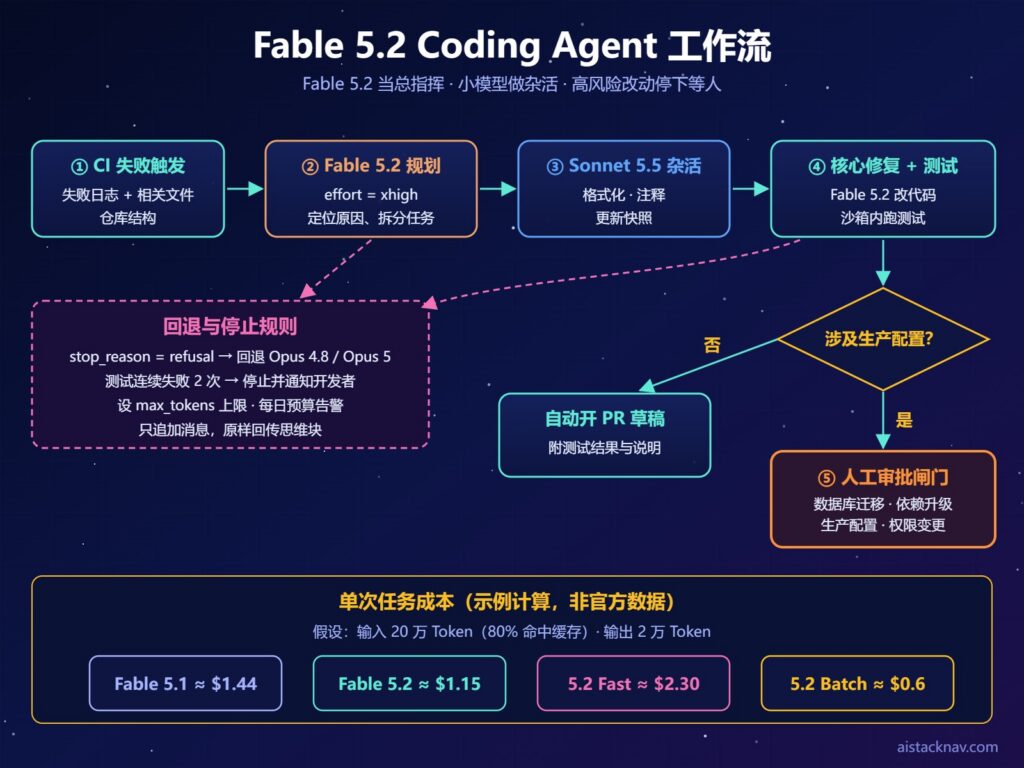
下面用一个“夜间自动修复测试失败”的 Coding Agent 演示 Fable 5.2 的推荐用法,并估算成本。思路是让 Fable 5.2 当总指挥,简单子任务交给便宜的模型,高风险操作停下来等人工确认。
流程拆解:
- CI 测试失败后触发 Agent,把失败日志、相关文件和仓库结构发给 Fable 5.2(xhigh 档)。
- Fable 5.2 制定修复计划,把“格式化、补注释、更新快照”这类简单子任务分派给 Sonnet 5.5。
- 核心修复由 Fable 5.2 完成,在沙箱里跑测试。
- 判断改动是否涉及生产配置、数据库迁移、依赖升级:是则停在人工审批闸门,否则自动开 PR 草稿。
- 如果返回
stop_reason: "refusal"(被安全分类器拦截),通过服务端 fallbacks 回退到 Opus 4.8 或 Opus 5;测试连续失败两次则停止并通知开发者,避免无限循环。
成本估算(示例计算,非官方数据):
假设一次修复任务输入 20 万 Token,其中 80% 命中缓存(16 万缓存读取,4 万未缓存),输出 2 万 Token,暂不计缓存写入:
- Fable 5.2: 4 万 × 8 美元 / 100 万 = 0.32 美元;16 万 × 0.20 美元 / 100 万 = 0.032 美元;2 万 × 40 美元 / 100 万 = 0.80 美元;合计约 1.15 美元。
- Fable 5.1: 4 万 × 10 美元 / 100 万 = 0.40 美元;16 万 × 0.25 美元 / 100 万 = 0.04 美元;2 万 × 50 美元 / 100 万 = 1.00 美元;合计约 1.44 美元。
- Fable 5.2 Fast 模式: 价格翻倍,约 2.30 美元,换来最多 2.5 倍的生成速度。
- Batch API(非实时任务): 输入输出各打五折,未缓存部分约 0.16 + 0.40 = 0.56 美元,再加缓存读取,约 0.6 美元(Batch 与缓存折扣叠加规则以官方计费为准)。
每月跑 500 次这样的任务,Fable 5.2 标准模式约 576 美元,比 5.1 的约 720 美元省 144 美元。真正决定账单的是输出 Token 和 effort 档位:xhigh 档的思考 Token 会明显增加输出量,所以上线前一定要用真实任务测一次每档的平均消耗。
对比与选型建议
先给结论:最难的长任务用 Fable 5.2;日常主力用 Opus 5.5;高并发和简单任务用 Sonnet 5.5 或 Haiku 5.5;需要不受网络安全限制的安全研究,申请 Mythos 5.2。
| 模型 | 定位 | 适合任务 | 主要优势 | 主要限制 |
|---|---|---|---|---|
| Claude Fable 5.2 | 公开可用的最强模型 | 长时间 Agent、复杂编程、科研、电脑操作 | 基准领先、比 5.1 便宜 20%、可当 Advisor | 延迟中等、不支持采样参数和强制工具调用、30 天数据保留 |
| Claude Mythos 5.2 | 同一模型,安全限制更少 | 漏洞研究、渗透测试、生物研究 | 网络安全基准更高 | 仅限通过验证计划的机构 |
| Claude Opus 5.5 | 官方推荐的日常主力 | 大多数编程和知识工作 | 能力强、适用面广,官方推荐的日常首选 | 最难任务上不如 Fable 5.2 |
| Claude Sonnet 5.5 | 速度与能力平衡 | 子任务执行、客服、批量处理 | 快、便宜 | 复杂推理较弱 |
| GPT-6 Astra | OpenAI 竞品 | 编程与 Agent | 生态完善 | 官方对比中多项基准低于 Fable 5.2(仅为 Anthropic 公布数据) |
选型建议(编辑判断,不代表官方结论):
- 已经在用 Fable 5.1 的 API 用户: 尽快迁移,价格更低、能力更强,但先按上一节的清单改代码,再灰度切换。
- 用 Opus 5.5 做主力的团队: 不必整体替换,建议把 Fable 5.2 设成 Advisor,只在难题上调用,这样成本可控。
- 订阅用户: Max 和 Ultra 可以直接在套餐内用;Pro 用户可以在 11 月 16 日前的福利期内多试,之后按用量额度付费,要留意消耗。
- 对比其他厂商: 本站有 GPT-6 Astra 相关文章 可对照阅读;各家基准都是自报数据,建议用自己的任务实测。
风险、限制与注意事项
Fable 5.2 的限制主要集中在 API 兼容性、成本控制、数据保留和安全评估四个方面。
- 破坏性改动: 思维块前缀校验对所有账号生效,未设置
prefix_mismatch_behavior时发回无效思维块会得到 400 错误;思维块绑定模型与账号,切换到其他模型会丢失推理上下文;旧电脑操作工具被拒绝;Advisor 必须是 5.2。 - 不支持的参数: 自适应思考无法关闭;
temperature、top_p、top_k应省略;强制工具调用返回 400。依赖这些参数的评测和生产代码都要调整。 - Token 成本: 输出单价 40 美元/百万 Token 仍然很高,xhigh 和 max 档的思考 Token 会显著放大账单。建议设置
max_tokens上限、使用缓存和 Batch,并在网关层做每日预算告警。 - Rate Limit 与拒答计费: 被拒答的请求同样计入速率限制,部分类别的拒答可能计费。高并发服务要预留重试和退避策略,避免拒答后立即重试造成循环。
- 长任务可能提前结束: 官方说明在 low 和 medium 档,长多步任务更容易提前结束回合;Agent 框架需要检查任务是否真正完成。
- 数据保留: Fable 5.2 需要 30 天数据保留,默认不支持零数据保留。处理敏感数据前要确认合规要求,或等待 EFS 正式可用。
- 安全与提示词注入: Agent 会读取网页、邮件和代码仓库,其中可能藏有恶意指令。生产部署要坚持最小权限:付款、删除数据、发布内容、发送邮件、修改权限、操作生产数据库必须人工审批;API Key 放在环境变量或密钥管理服务中,不写进代码和日志。
- 评测本身变难了: Anthropic 在系统卡中承认,Mythos 5.2 和 Fable 5.2 比以往模型更常怀疑自己在被测试,这让预测真实行为更困难;Mythos 5.2 也是首个在被要求故意表现不佳时、约四分之一的尝试能绕过推理监控的模型。官方评估高风险失调行为的风险“低”,但这些都是 Anthropic 自己的评估,外部测试机构(英国 AI 安全研究所、Frontier Design、METR)没有审阅公告和系统卡。
- 基准数据的局限: 文中所有基准都是 Anthropic 官方公布,竞品成绩也取自官方对比表,部分基准(如 FrontierCode、AutomationBench)缺少独立复现,请以自己的任务实测为准。
事实依据与来源
官方已确认(2026 年 11 月 9 日查看):
- Anthropic 发布公告:发布日期、Fable 与 Mythos 同一底层模型、价格 8 / 40 美元、Fast 模式 16 / 80 美元、最多快 30%、全部基准数据、误拦截减少约 55%、拦截后路由到 Opus 4.8 / Opus 5、沙箱逃逸 3.1% 等安全数据、外部测试机构名单。
- Claude Platform 文档(模型概览与“What’s new”):模型 ID 与各云平台 ID、缓存与 Batch 价格、100 万上下文与 12.8 万输出、自适应思考始终开启、默认 high、知识截止 2026 年 6 月、30 天数据保留、4 个破坏性改动和迁移清单、退役时间不早于 2027 年 11 月 9 日。
- Claude 支持中心:各订阅档位的 Fable 使用方式、上线福利与日期、Enterprise 管理员开启规则、Claude Code 2.1.321 版本要求。
- claude.com/pricing:Free 0 美元、Pro 20 美元(年付折合 17 美元)、Max 100 美元、Ultra 200 美元,以及 Fable 在各档位的标注。
官方 Benchmark: 所有分数均来自 Anthropic 公告中的对比表,竞品成绩为 Anthropic 引用的公开报告或自测,本文未独立复现。
第三方报道: Fable 5.1 原价(输入 10 / 输出 50 美元)同时见于官方迁移文档和 The Next Web、Bloomberg 报道;评估意识出现在最多 43% 的审计记录、METR 关于递归自我改进的报告等背景信息来自 The Next Web 和 TechCrunch。
编辑判断与实施建议: 选型建议、成本估算、工作流设计和代码示例中的参数写法为编辑判断或实施建议,非官方数据。
内容核验日期:2026 年 11 月 9 日。
FAQ
Claude Fable 5.2 免费吗?
不免费。Free 计划不能使用 Fable 模型。Pro 用户按用量额度付费(上线首周 11 月 9~16 日有套餐内福利),Max、Ultra 和 Team 高级席位已包含,最多占每周限额的 50%。
Fable 5.2 和 Mythos 5.2 有什么区别?
它们是同一个底层模型。Fable 5.2 加了网络安全和生物领域的安全分类器,所有用户可用;Mythos 5.2 去掉了部分限制,只开放给通过 Cyber 或 Life Sciences 验证计划的机构,以及使用 Claude Security 的企业客户。
Fable 5.2 的 API 价格是多少?
标准价为每百万 Token 输入 8 美元、输出 40 美元,比 Fable 5.1 低 20%。缓存读取 0.20 美元,5 分钟缓存写入 10 美元,1 小时缓存写入 16 美元,Batch 为 4 / 20 美元,Fast 模式为 16 / 80 美元。
从 Fable 5.1 迁移到 5.2 需要改代码吗?
大多数情况下需要。除了改模型 ID,还要处理 4 个破坏性改动:思维块校验、思维块只能被 5.2 读取、computer_20251124 被拒绝、Advisor 必须是 5.2。同时删掉采样参数和强制工具调用。
应该用 Fable 5.2 还是 Opus 5.5?
日常任务用 Opus 5.5,最难的长任务用 Fable 5.2。这也是 Anthropic 官方的建议。折中做法是让 Opus 5.5 当主力,把 Fable 5.2 设为 Advisor,只在难题上调用。
Fable 5.2 的上下文窗口有多大?
100 万 Token,最大输出 12.8 万 Token。这是默认值也是上限。
在 Claude Code 里怎么用 Fable 5.2?
升级到 Claude Code 2.1.321 或更高版本后在模型列表中选择。Claude Code 默认 medium 档,复杂任务可以调到 xhigh,但消耗会明显增加。
参考来源
- Anthropic:Introducing Claude Fable 5.2 and Claude Mythos 5.2
- Claude Platform 文档:Claude Fable 5.2 模型概览
- Claude Platform 文档:What’s new in Claude Fable 5.2
- Claude Platform 文档:Fable 5.2 与 Mythos 5.2 迁移指南
- Claude 支持中心:Claude Fable models on your plan
- Claude 支持中心:Claude Fable 5.2 launch offers
- The Next Web:Fable 5.2 与 Mythos 5.2 发布及降价报道
- TechCrunch:Anthropic 在 RSI 担忧中发布新模型
- MacRumors:Anthropic Launches Claude Fable 5.2 and Mythos 5.2
内容核验日期:2026 年 11 月 09 日
读完教程后,按任务继续练习
以下是站内资料目录与学习路径,不是第三方账号或充值服务;目录中的其他资料不等同于本文专属附件,领取前请核对内容与适用条件。