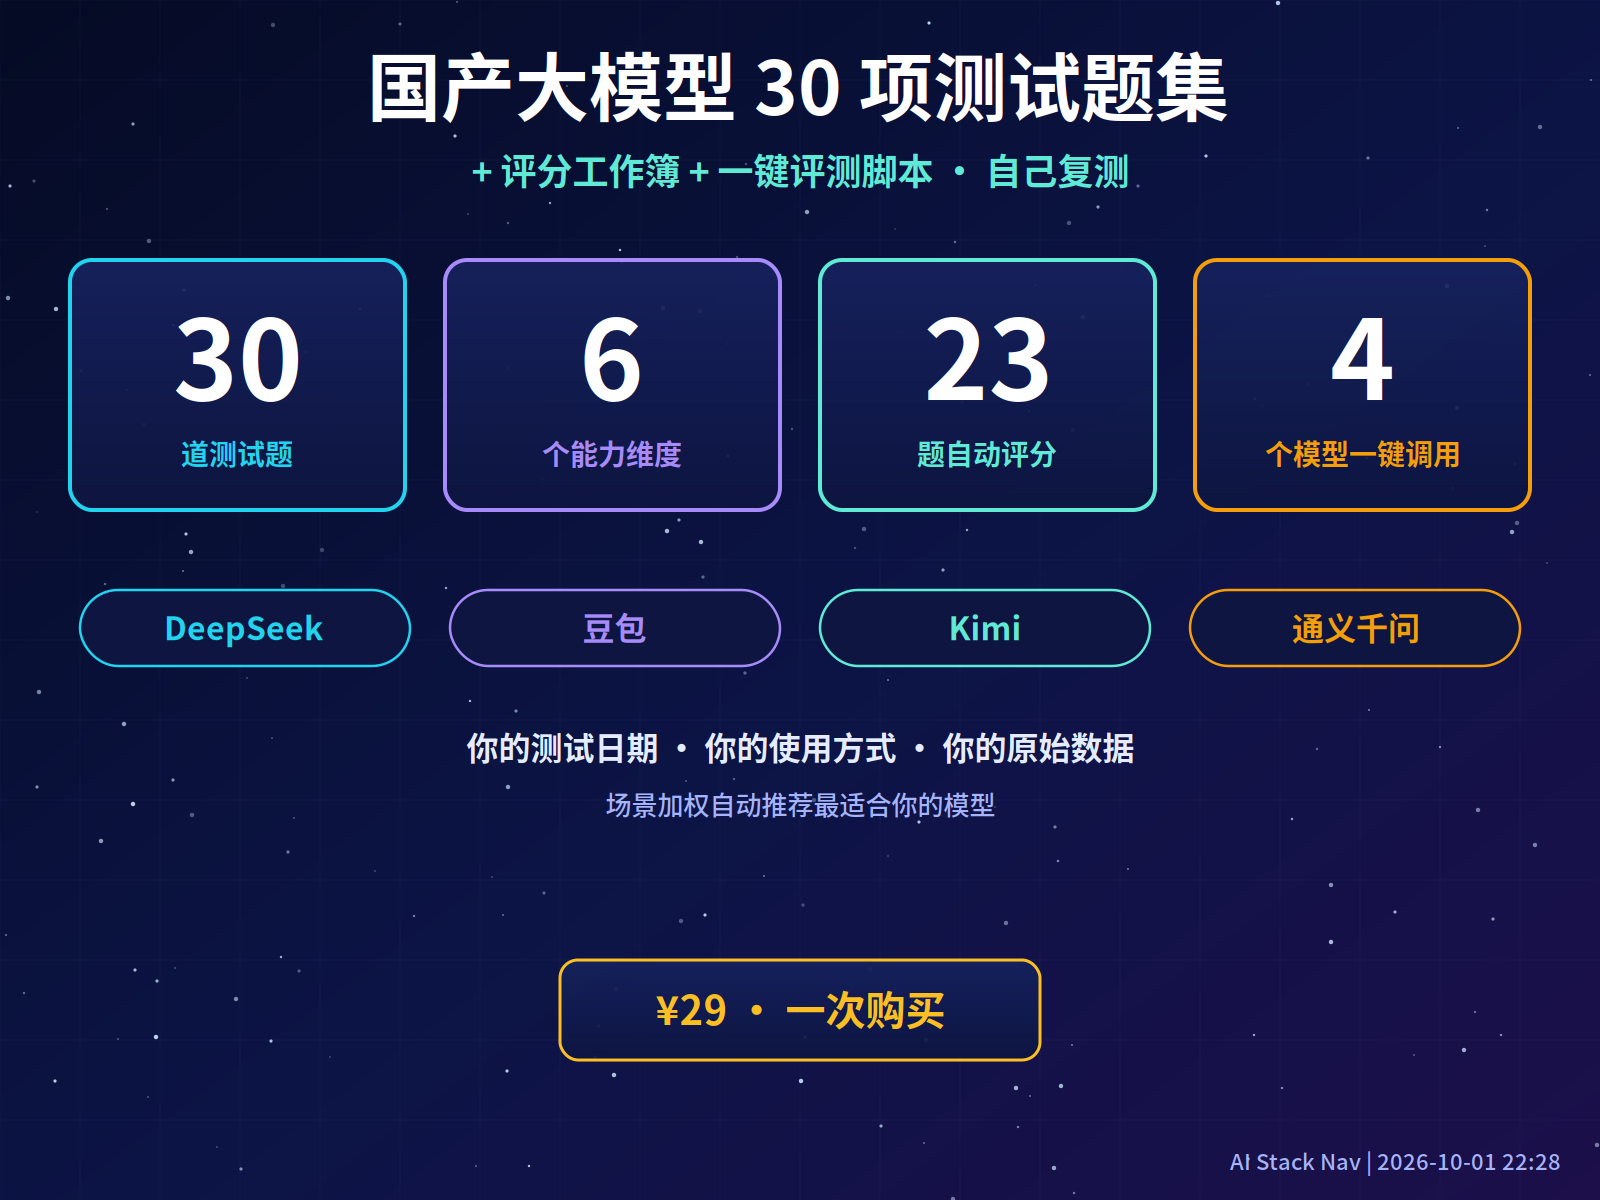
DeepSeek、豆包、Kimi、通义千问到底选哪个?与其相信不知道什么时候测的排行榜,不如用同一套题自己测一遍。这套资料给你题目、评分标准、评分工作簿和一键评测脚本,一小时内得到属于你自己的、可复核的结论。
一、核心功能
- 30 道覆盖 6 个维度的测试题:中文写作、推理与数学、信息抽取、代码能力、事实与时效、指令遵循与安全,各 5 题;题目中的合同、会议记录等材料均为虚构,客观题标准答案已用程序验证。
- 23 道题自动评分:标准答案、JSON 格式、字数与行数、禁止词、正则与代码单元测试,脚本自动判定;7 道主观题附评分要点,0~5 分人工打分。
- 一键调用四个模型:评测脚本通过 OpenAI 兼容接口调用 DeepSeek、豆包、Kimi、通义千问,自动保存每道题的原始回答、耗时与 token 用量,对限流和服务端错误自动重试。
- 场景加权自动推荐:Excel 评分工作簿按维度汇总,按“写作与自媒体 / 开发与编程 / 办公与文档处理 / 均衡使用”四种场景加权,权重可改,自动显示最适合你的模型。
- 不会编程也能测:附 30 道题打印版,在网页或 App 中逐题提问、按要点打分即可。
- 和免费决策表相比:免费的《一页纸选型决策表》帮你按需求初步缩小范围;付费包让你用统一方法亲自测试、保存原始数据并得出加权结论。
二、适合人群
- 为团队选择统一 AI 工具的负责人:用同一套题让团队成员分工测试,结论有据可查。
- 为产品选择 API 的开发者:一次脚本拿到四家的回答、耗时、token 用量和失败率。
- 需要发布评测内容的自媒体与博主:方法透明、题目公开、原始数据可复核。
- 想找主力 AI 助手的个人用户:按自己的场景加权,选出最适合自己的。
- 不适合:想直接拿一份“现成排名”的用户——本资料包不含预填的真实评分,结论需要你自己测出来。
三、购买后获得什么
| 文件 | 内容 | 规模 |
|---|---|---|
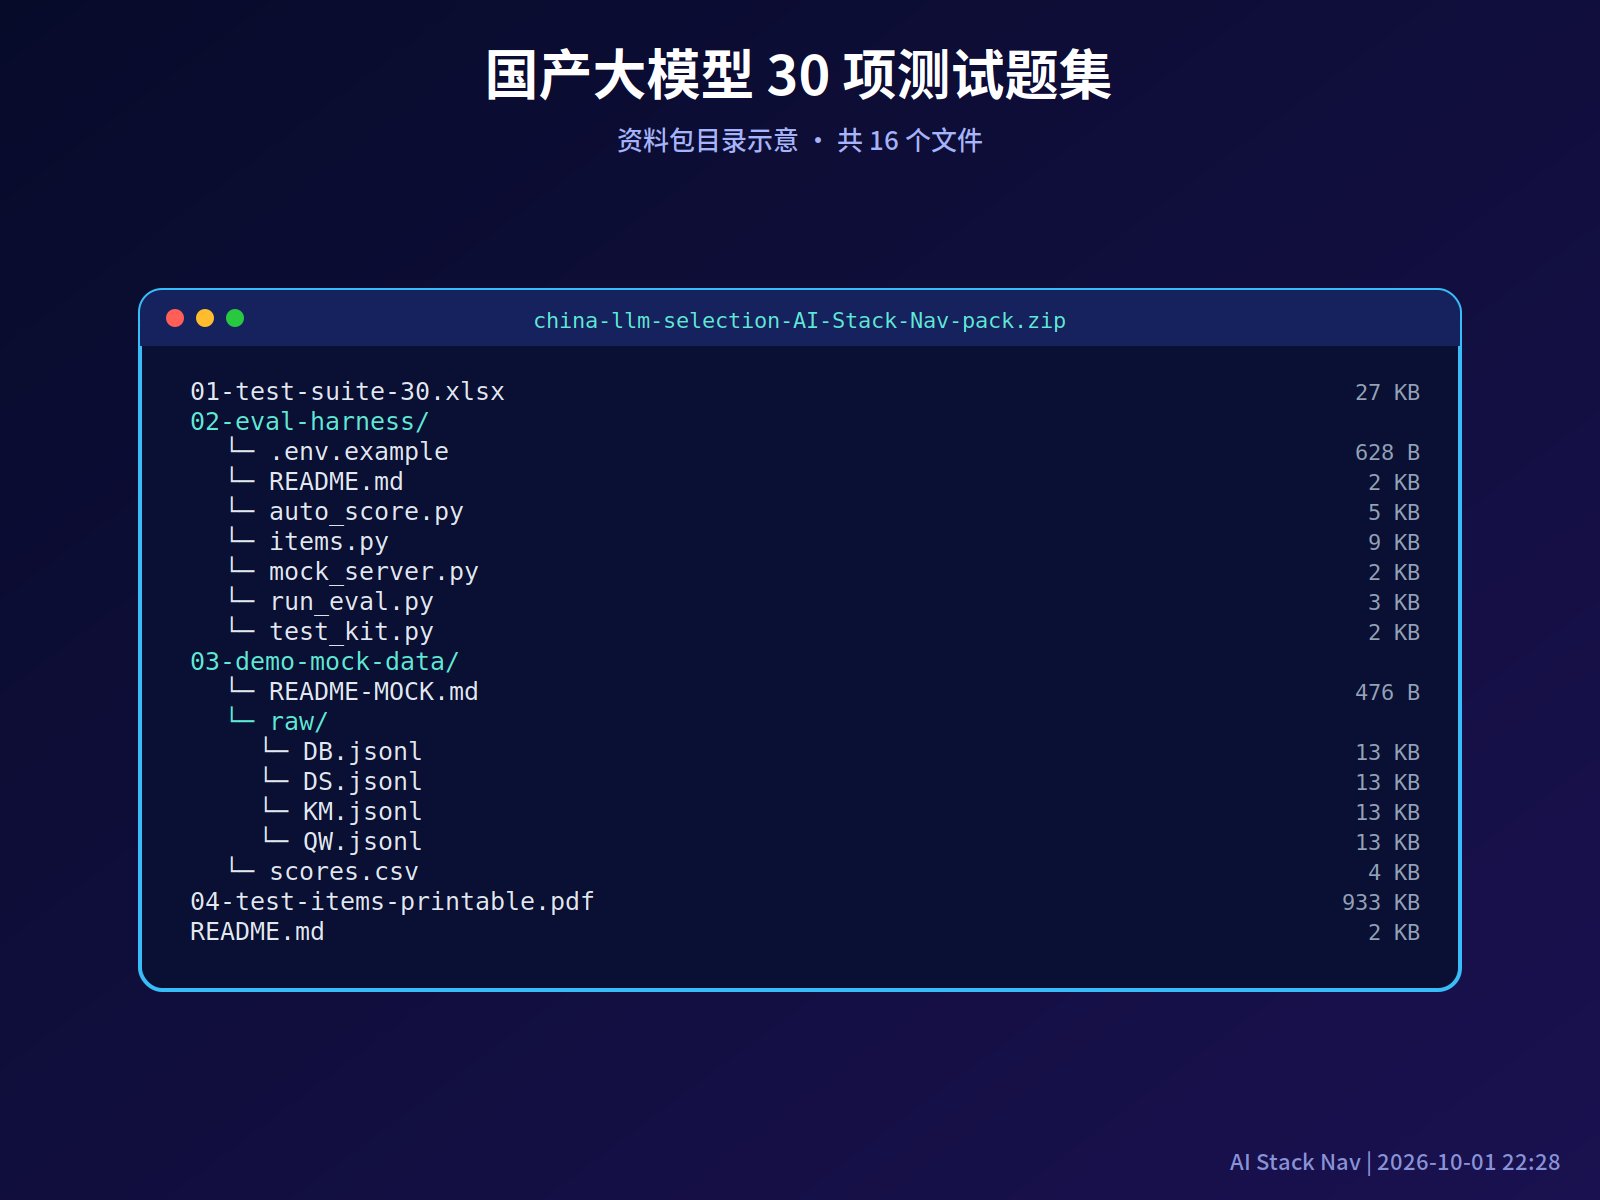
01-test-suite-30.xlsx |
题目、评分表、维度汇总、场景加权、原始数据模板、模拟示例 | 30 题 × 4 个模型 |
02-eval-harness/ |
评测脚本、自动评分脚本、模拟上游、单元测试、配置示例 | 只用 Python 标准库 |
03-demo-mock-data/ |
模拟数据,演示输出格式(非真实模型输出) | 4 个通道 × 30 题 |
04-test-items-printable.pdf |
30 道题打印版,含评分要点 | 6 页 |
README.md |
内容清单、使用方法、使用边界 | 1 份 |
四、包含哪些内容
- 原始评测数据怎么来:运行评测脚本后,每个模型的回答保存在
raw/DS.jsonl、raw/DB.jsonl、raw/KM.jsonl、raw/QW.jsonl,自动评分结果保存在scores.csv,都可以随时复核和复测。 - 成本参考:30 道题测四个 Flash 级模型,按示例计算整轮 API 费用通常在 1 元以内(实际以各平台价格为准)。
五、售后边界与免责声明
- 本资料用于学习、研究、项目搭建和合法商业应用。
- 本资料包提供评测方法与工具,不含预填的真实评分;
03-demo-mock-data为本地模拟数据,不代表任何模型的真实表现,请勿引用。 - 不包含任何平台的 API 费用、会员或额度;各平台接口地址、模型 ID 与价格以官方控制台为准。
- 第三方平台、模型、接口、价格与政策可能随时调整,不保证所有第三方服务永久可用;模型持续更新,评测结果有时效性。
- 使用者需自行遵守所在地法律法规、第三方平台条款与数据合规要求;API Key 请妥善保管,
--exec-code功能请仅在隔离环境中使用。 - 不提供违法违规、绕过平台限制、滥用接口、未授权数据抓取等用途的支持;请勿将编程套餐的接口与 Key 用于评测脚本。
- 数字资料一经下载,退换规则按 AI Stack Nav 网站政策执行;仅限购买者个人或本团队内部使用,请勿转售或公开传播。
常见问题
是否包含 AI 工具会员或额度?
不包含。第三方费用需另行支付。
购买后有哪些文件?
包含测试题 Excel、评测脚本、模拟数据、题目打印版 PDF 和 README。