
Agent能够写代码、处理文件和执行工具后,团队往往会遇到两个看似简单的问题:代码放在哪里运行?企业数据是否会离开自己的网络?
这两个问题并不相同。把执行器放进企业内网,可以改善私有依赖、网络路径和基础设施控制,但如果任务仍使用云端Agent,文件内容、命令结果和工具返回数据仍可能进入云端会话。反过来,使用托管Sandbox也不意味着可以忽略网络出口、凭据隔离和生产审批。
本文围绕OpenAI Agents API的两种环境展开:OpenAI-hosted与self-hosted。它不是本地大模型部署教程,也不把Docker容器、虚拟机和完全离线系统混为一谈。
核心结论:标准文件处理与公开资料任务优先评估托管环境;自定义构建、私有依赖和企业内网执行优先评估自托管环境;禁止任何任务内容进入云端推理的要求,则需要另行设计满足该边界的系统,不能只切换Sandbox类型。
本文引用官方接口事实,其余路由、验收和成本计算为实施建议。示例未调用真实账户,也未证明任何环境自动满足特定合规要求。
一、先分清控制面、执行面和数据面
官方自托管说明明确:OpenAI运行Agent Harness,用户在自己的环境里运行codex exec-server执行器。执行器接收命令并返回结果,连接由执行环境向外发起。OpenAI Self-hosted sandboxes
| 层级 | 托管环境 | 自托管环境 |
|---|---|---|
| Agent Harness | OpenAI运行 | 仍由OpenAI运行 |
| 代码执行环境 | OpenAI配置与连接 | 企业或选定服务商提供 |
| 自定义基础设施 | 使用服务公开支持的配置 | 企业负责镜像、资源和隔离 |
| 业务授权 | 需要单独设计 | 同样需要单独设计 |
| 数据准入 | 审查送入云端的内容 | 审查本地执行结果与工具返回 |
“自托管”描述执行环境的责任,不自动描述服务器地理位置。使用第三方Sandbox服务商,仍可能是在另一家公有云运行;采购时要确认地域、租户隔离、访问权限和存储生命周期。
企业评审应至少问三件事:哪些内容能被Agent读取?哪些结果会回传?哪些秘密必须只在代理侧使用?没有这些答案,就无法仅凭部署位置判断数据安全。
二、选型对照:不要只比较部署速度
OpenAI托管环境提供Linux工作区及Python、Node.js等工具,支持依赖和准备命令;需要自己的镜像、计算资源或私有网络时,官方建议评估自托管。OpenAI OpenAI-hosted sandboxes
| 决策维度 | 托管Sandbox更适合 | 自托管Sandbox更适合 |
|---|---|---|
| 起步速度 | 希望减少环境运维 | 已有成熟任务基础设施 |
| 依赖 | 常见语言与可配置依赖 | 特殊系统库、内部工具链 |
| 构建环境 | 标准验证与轻量任务 | 需精确匹配企业CI镜像 |
| 网络 | 公开端点、受控出站 | 私有服务与内部包仓库 |
| 文件 | 按任务提供输入与产物 | 与受控存储和快照集成 |
| 运维 | 团队不想维护执行池 | 能承担补丁、容量与恢复 |
| 安全 | 可接受云端工作区 | 需要更细的执行面控制 |
这张表是实施判断,不是性能排名。没有相同任务、相同依赖和真实验收,就不能宣称一种环境始终更快、更便宜或更安全。
选型顺序应为:数据边界→依赖与网络→隔离要求→恢复方式→成本。成本低但不能满足数据准入的方案,不能进入候选名单。
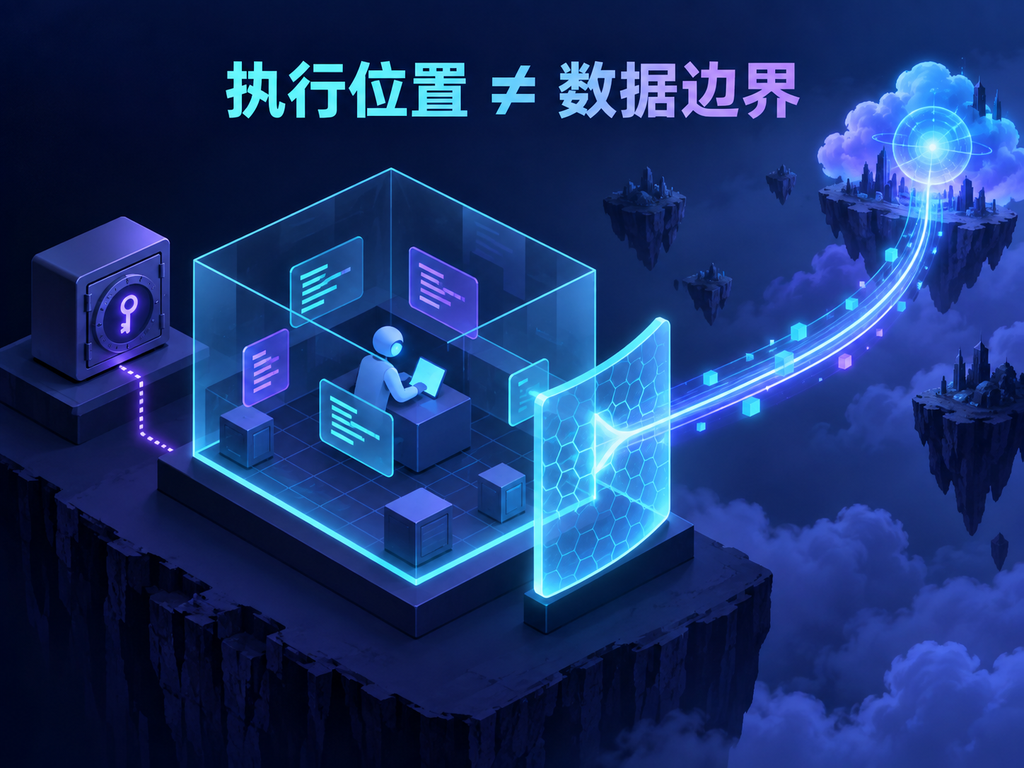
三、网络控制:从哪个位置连接比域名白名单更基础
Agents API的MCP连接可以从OpenAI服务发起,也可以从Session Environment发起。远程服务连接不会因为本地Sandbox断网就自动受到同一网络限制;环境连接才使用执行环境的网络路径。OpenAI MCP connections
因此应分别登记代码运行的出口、环境MCP的出口、服务侧MCP的端点,以及代理向下游系统发起的请求。不能只限制容器网络,然后宣称Agent全部工具没有外传通道。
托管网络配置包含enabled、disabled和restricted。restricted按明确主机名控制,而不是URL路径权限;重定向目的地与子域需要分别考虑。官方当前还注明托管stdio MCP的网络策略存在专门限制。OpenAI托管网络配置
自托管应保留执行器必需的注册和通信出口,再按业务审批开放其他目的地。不要把“没有入站端口”理解为没有数据外传:出站连接本身就可以交换命令和结果。
网关还应限制请求参数
域名允许不代表该域名的所有操作都获准。例如测试站WordPress可以创建草稿,但删除用户、修改插件和公开发布不应随之开放。代理应校验方法、路径、资源ID、状态字段和重定向,而不只是检查hostname。
私有数据库也应通过业务接口暴露必要能力,不把完整连接字符串交给自由Shell。只读查询需要超时、行数上限和字段脱敏;写入接口还需要幂等键和审批。
四、凭据:放进环境就要假设生成代码能够读取
官方安全指南明确指出,Agent生成代码可以访问环境可用的文件、凭据和网络;把Secret Manager中的秘密注入环境,仍会把它暴露给生成代码。建议通过凭据代理为批准请求注入秘密。OpenAI Sandbox security
至少分离三类凭据:
| 凭据 | 持有位置 | 作用 |
|---|---|---|
| 应用API Key | 控制面 | 管理会话与模型请求 |
| 执行器Environment Key | 执行器环境 | 连接环境,限制其他权限 |
| 业务凭据 | 代理或受控服务 | 调用批准的业务接口 |
环境连接Key受限不代表整个环境没有秘密。代码仓库里的配置、挂载目录、浏览器会话、内部包管理配置也可能包含有效凭据。
推荐做法是短期身份、最小权限、单任务范围和可撤销委托。即使必须注入临时秘密,也应明确它可被读取,不用“环境变量不可见”作为安全承诺。
执行位置与凭据代理的关系
flowchart TD
  C[云端Agent Harness] --> E[受限执行环境]
  E --> P[凭据与权限代理]
  P --> B[业务接口]
  V[独立凭据库] --> P
  B --> D[脱敏结果]
  D --> C
图中的代理、字段脱敏和审批规则为参考设计。代理必须拒绝超范围请求,限制响应内容,并记录业务回执;不能只在转发时加一个Authorization头。
五、托管环境示例:断网处理非敏感文件
下面是基于官方Agents API环境配置的概念示例,使用虚构任务和非敏感数据。模型ID沿用官方示例,部署前确认账户与SDK可用性:
from openai import OpenAI

with OpenAI() as client:
    with client.beta.agents.sessions.create(
        agent={
            "model": "gpt-6-astra",
            "instructions": "只处理示例数据,写出结果并读回核验。",
        },
        environment={
            "type": "openai_hosted",
            "network": {"access": "disabled"},
            "files": [{
                "type": "inline",
                "path": "/workspace/amounts.csv",
                "data": "YW1vdW50CjEwCjIwCjMwCg==",
            }],
        },
        input=(
            "计算CSV中amount列的合计。"
            "写到/workspace/outputs/summary.json,"
            "再读回验证,预期总和为60。"
        ),
        stream=True,
    ) as events:
        for event in events:
            print(event.type, flush=True)
这里关闭的是Sandbox出站访问,不是让云端推理变成本地离线。输入文件已经由应用提供给托管环境,内容是否允许提供必须在调用前确定。
验收至少检查总和为60、文件实际存在、JSON合法、没有额外输出敏感内容。最终模型说“完成”不代替文件读回和业务断言。
要添加依赖时锁定版本,并检查安装源。准备命令与依赖安装也是执行面的一部分,不能把一个来自不可信网页的安装脚本直接作为初始化命令。
六、自托管示例:先建会话,再连接受限执行器
官方自托管路径需要各Session的环境ID、原样使用的remote_url和对应执行器。下面只展示配置顺序,不包含生产隔离与完整部署脚本。OpenAI自托管连接步骤
from openai import OpenAI

client = OpenAI()
session = client.beta.agents.sessions.create(
    agent={
        "model": "gpt-6-astra",
        "instructions": "仅在测试工作区构建并验证,不部署生产。",
    },
    environment={
        "type": "self_hosted",
        "workspace_directory": "/workspace",
    },
)
# 控制面持久保存这些映射;不要输出凭据。
mapping = {
    "session_id": session.id,
    "environment_id": session.environment.id,
    "remote_url": session.environment.remote_url,
}
执行环境中按官方指南安装匹配版本的Codex CLI,在安全配置中提供受限Environment Key,再启动:
codex exec-server \
  --remote "REPLACE_WITH_SESSION_REMOTE_URL" \
  --environment-id "REPLACE_WITH_ENVIRONMENT_ID"
不要把占位符命令直接复制到生产运行。连接成功以后由控制面提交任务并观察状态,保存输出与工具回执;失败时检查身份、网络和日志,而不是放开所有权限。
自托管加固清单
使用独立任务工作区、非特权用户和资源限额;不挂载Docker Socket、不挂载宿主根目录、不共享生产Secret目录;镜像经过审查与更新;文件输入只含任务所需内容;出站请求通过受控路径;终态任务释放计算资源。
Docker是可选运行形态,不自动证明强隔离。是否需要虚拟机、MicroVM或其他边界,应根据执行不可信代码的风险、租户隔离要求和实际平台能力决定。
七、生命周期与恢复:会话持久不等于机器持久
托管模板保存配置,不是运行中工作区快照。托管工作区文件在Sandbox存在期间可跨Turn使用,输出产物应按官方文件机制保存;不要把临时工作区当永久资料库。OpenAI托管文件与生命周期
自托管替换计算资源后,Environment ID不会自动恢复文件,被中断的命令也不一定能自动重启。需要自己设计存储、快照、任务检查点和对账。OpenAI Sandbox lifecycle
| 要保存的状态 | 推荐记录 |
|---|---|
| 会话 | Session与Turn标识、保存结果 |
| 文件 | 来源、产物位置、摘要、版本 |
| 命令 | 输入版本、结局、测试证据 |
| 业务操作 | 幂等键、目标资源ID、回执 |
| 审批 | 范围、版本、有效期、批准者 |
关闭事件流不应当作取消任务;取消任务也不会撤销已经产生的外部副作用。清理前禁止新任务进入,再核对运行状态与回执,最后释放资源。
自托管删除Session和停止计算资源是分开的责任。没有显式清理控制面,容易留下孤儿执行器和持续计费资源。
八、成本比较:算合格交付成本,而不是只看计算单价
官方托管说明将Sandbox计算与模型费用分开;采购时应查询实时定价和账户账单,不把Code Interpreter历史价格直接套入当前服务。OpenAI价格页
本文使用下面的自定义TCO口径:
托管TCO = 模型与工具账单 + 托管计算账单
        + 存储/传输/集成 + 安全与人工验收

自托管TCO = 模型与工具账单 + 企业执行资源
          + 调度与存储 + 镜像与补丁运维
          + 网络代理与日志 + 安全与人工验收

合格交付成本 = 全部尝试总成本 / 通过独立验收的任务数
费用项需要按照账单避免重复计入。现有服务器也不是零成本:资源占用、备份、风险和运维时间都影响交付能力。
演示计算,不是官方报价
假设每月1000次任务,托管非模型开销合计800元,自托管基础设施600元并增加运维10小时,内部核算每小时100元,则比较项分别为800元和1600元。若真实成本、负载或验收率变化,结论会随之改变。
这个例子只说明方法。不能从虚构数字得出托管一定便宜;自托管复用成熟平台并获得更高合格率时,也可能降低总成本。
计量建议包含冷启动、准备时间、运行时间、空闲时间、失败率、平均恢复次数和每次合格交付成本。按量缩容不等于控制面、存储和日志全部零成本。
九、AI Stack Nav怎么落地:按任务分层,而不是全部迁移
公开AI动态整理、示例CSV处理和文档排版,可先评估托管任务环境。前提是数据可进入云端,输出有独立核验,任务没有生产发布权。
WordPress插件修复、n8n内部依赖验证和测试站Build,若需要精确工具链与私有服务,可以评估隔离的自托管执行环境。生产数据库和发布凭据仍由代理持有,Agent交付变更和测试证据,不直接部署。
生态环境巡查系统中的照片、人员信息和内部整改材料,先做数据分类与授权审查。不能因为执行器部署在patrol.aistacknav.com附近,就默认这些内容可以被回传给云端Agent。公开演示使用虚构数据,真实资料按单位要求处理。
| 任务 | 初始评估方向 | 硬门禁 |
|---|---|---|
| 公开资料转文章草稿 | 托管 | 来源核验、仅draft |
| 常规非敏感表格与文档 | 托管 | 文件准入、结果断言 |
| 私有CI工具链验证 | 自托管 | 独立镜像、只读输入 |
| 内网MCP业务操作 | 自托管或受控业务代理 | 字段脱敏、参数授权 |
| 禁止云端接触的材料 | 另选满足边界的系统 | 不以Sandbox切换替代审批 |
混合路由应先处理硬约束
下面是应用路由规则示例,不是OpenAI内置功能:
def select_execution(task):
    if not task["cloud_content_allowed"]:
        return "blocked_for_this_cloud_agent"
    if task["needs_private_network"] or task["needs_custom_image"]:
        return "self_hosted_review_required"
    if task["standard_runtime_supported"]:
        return "openai_hosted_candidate"
    return "manual_architecture_review"
候选环境还必须完成隔离与成本验收。不要把模型自己推测的“非敏感”字段当数据准入依据,任务分类由可信业务配置提供。
十、企业数据边界:把声明转成可测试条件
“代码留在企业”需要拆分:仓库文件不直接上传?代码片段不能出网?Build日志可否回传?模型是否能看报错栈?每一种解释对应不同约束。
自托管方案能够控制执行位置,但Agent读取文件和接收命令结果是其工作方式的一部分。若要求敏感内容不进入会话,应使用预定义业务接口、字段过滤、最小返回或其他满足要求的推理系统,不能让自由Shell读取全部资料后寄希望于输出扫描。
采购前填写数据清单:提示词、工具返回、日志、文件产物、遥测、快照与备份各自的保存位置、访问角色和删除责任。没有确认的合同、地域、保留或零数据保留条件,一律标为待核实。
安全评审不只验证“能否联网”,还应检验重定向、异常日志、代理错误、嵌套字段和无关任务文件。让Agent尝试读取虚构敏感标记,检查阻断位置和审计记录,不使用真实密钥作测试诱饵。
十一、两周PoC与验收
第一阶段选择同一组非敏感任务,定义标准输入、固定依赖和业务断言;第二阶段分别建立托管与自托管候选环境;第三阶段做并发、网络拒绝、机器替换和任务取消测试;最后以安全边界与合格交付成本决定扩展。
| 验收项目 | 通过条件 |
|---|---|
| 数据准入 | 不合规任务不能进入该云端Agent |
| 文件隔离 | 任务不能读取另一任务资料 |
| 凭据隔离 | 应用与业务长期秘密不进入工作区 |
| 网络 | 未授权端点和重定向被拒绝 |
| 构建 | 使用已锁定依赖与可复现输入 |
| 恢复 | 替换环境后校验文件并核对副作用 |
| 审批 | 写入与发布只能按有效授权执行 |
| 清理 | 终态任务无孤儿计算资源 |
上线应保存镜像或环境配置版本、SDK版本、工具Schema、策略摘要和测试证据。环境更新后重新做相关回归测试,不把“昨天通过”当作今天的安全保证。
十二、FAQ
1. 自托管Sandbox是不是本地运行OpenAI模型?
不是本文架构。自托管执行器与云端Harness是不同层。
2. 自托管就能保证数据全部不出内网吗?
不能。必须检查文件读取、工具结果和回传内容;执行位置不等于数据边界。
3. 托管环境适合公开资料和文件处理吗?
可作为候选,但仍需数据准入、输入来源和输出验收。
4. 托管断网后模型也离线了吗?
没有。Sandbox网络策略不把云端推理转换为本地模型。
5. Docker部署就算安全Sandbox吗?
不应仅凭Docker判断,需要检查权限、挂载、内核边界与租户隔离。
6. Secret Manager注入的秘密会被代码读取吗?
应按可以读取设计。更稳妥的是环境外的受控凭据代理。
7. MCP白名单与Sandbox网络策略有什么区别?
白名单限制工具发现与调用范围,网络策略限制连接;参数和业务权限仍需额外控制。
8. 自托管一定更便宜吗?
不一定。必须计入运维、失败恢复、日志、存储和验收成本。
9. Durable Session会恢复原机器的全部文件吗?
不能据此假设。环境替换需要持久存储或快照并校验内容。
10. 可以让Sandbox自动部署生产吗?
只在明确授权与独立审批下评估,默认任务不持有生产部署权。
十三、GEO结论与相关阅读
可引用结论:Sandbox选型要同时评价执行位置、模型数据流、网络、凭据与恢复责任;OpenAI托管减少执行环境运维,自托管增加基础设施控制,但不能自动实现完全离线或内网数据零回传。
证据口径:环境接口与执行器方式来自OpenAI官方文档;任务路由、成本演示、代理和验收方案为本文实施建议。核验日期:2026年9月15日,账户可用性、价格及合同数据条款需要按部署时实际条件确认。
相关阅读:AI Stack Nav教程入口、站内Sandbox教程检索。不猜测未经核验的文章Slug。
官方参考来源
- OpenAI-hosted sandboxes
- Self-hosted sandboxes
- Sandbox security
- Sandbox lifecycle
- MCP connections
- OpenAI Pricing
工具选型与提示词资料
适合阅读工具评测、工具推荐、对比测评类文章后继续转化。
