摘要: Grok 4.7 的公开输入价格看起来并不高,但 Coding Agent 的真实成本不只来自第一次请求的 Token。多轮上下文回传、推理 Token、服务端工具调用、客户端 Shell 与 CI、失败重试、长上下文阶梯、人工复核和回滚都会放大总成本。本文基于 xAI 最新官方价格与成本追踪字段,给出一套可复现的 Grok 4.7 Coding 成本实测方法、Python 采集代码、三类任务账本和自动熔断策略。核心结论是:不要按“每百万 Token 单价”选 Agent,而要按“每个通过验收的任务成本”选。适合正在接入 Grok API、Grok Build、Cursor 或自建 Coding Agent 的开发者和企业团队。
核心结论
Grok 4.7 单 Token 便宜不等于 Agent 总成本低,因为 Agent 会循环执行“思考—读文件—调用工具—修改—测试—再思考”。真正应该比较的不是一次模型调用价格,而是完成一个通过测试、无需回滚的任务所消耗的模型、工具、算力与人工成本总和。
- 官方 Token 价格只是第一层:Grok 4.7 短上下文输入为 2 美元、缓存输入 0.50 美元、输出 6 美元/百万 Token;提示词达到 200K 后,整次请求进入输入 4 美元、缓存输入 1 美元、输出 12 美元的长上下文档位。
- Agent 工具另行计费:xAI 服务端 Web Search 与 Code Execution 当前均为 5 美元/千次调用;模型自主决定调用次数,任务越复杂,成本越容易扩张。
- 推理 Token 按输出价计费:只看最终回答字数会低估费用,必须读取响应中的 reasoning tokens 与官方实际成本字段。
- 最有价值的指标是 CPAT:Cost Per Accepted Task,即每个“通过验收任务”的成本。低价模型如果反复失败,CPAT 可能高于一次完成任务的高价路径。
- 建议立即建立成本账本与熔断:记录每个请求的
cost_in_usd_ticks、工具调用、墙钟时间、CI 成本、人工分钟和任务结果,并对 Token、工具轮次、时间和美元费用设置硬上限。
Grok 4.7 官方价格:便宜的是哪一部分
xAI 官方目前把 Grok 4.7 作为代码和通用文本任务的推荐模型,模型 ID 为 grok-4.7,上下文上限为 500K Token。全球 API 的短上下文标准价为:输入 2 美元、缓存输入 0.50 美元、输出 6 美元/百万 Token。提示词达到 200K Token 后,长上下文价变为输入 4 美元、缓存输入 1 美元、输出 12 美元/百万 Token。
| 成本项 | 短上下文 | 长上下文 | Agent 中的常见触发方式 |
|---|---|---|---|
| 非缓存输入 | $2 / 1M Token | $4 / 1M Token | 系统指令、代码、日志、工具结果、历史消息 |
| 缓存输入 | $0.50 / 1M Token | $1 / 1M Token | 重复的提示前缀和稳定上下文 |
| 输出与推理 | $6 / 1M Token | $12 / 1M Token | 最终回答、内部规划和推理 Token |
| Web Search | $5 / 1K 成功调用 | 同左 | 查文档、搜索错误与依赖信息 |
| Code Execution | $5 / 1K 成功调用 | 同左 | 服务端沙箱运行 Python 等代码 |
| Priority Processing | 标准 Token 价的 2 倍 | 标准 Token 价的 2 倍 | 追求更低排队与生成延迟 |
| 美国区域端点 | 全球价的 1.1 倍 | 全球价的 1.1 倍 | 需要美国境内推理和请求处理 |
长上下文价格最容易被误解。xAI 文档明确说明:一旦请求的提示词达到长上下文阈值,该请求中的全部 Token 都按长上下文费率计算,并非只有超过 200K 的部分涨价。缓存 Token 也计入阈值判断。因此,把整个仓库、长日志和重复工具输出不断追加到一次会话,可能造成阶梯式跳价。
另一个常见误区是 Grok 4.7 Fast。官方说明,Fast 是相同模型运行在更快基础设施上,Token 价格为标准版两倍,且只在 Cursor 与 Grok Build 中提供,不是公共 xAI API 模型。使用 Cursor 时还要以 Cursor 套餐的实际计费规则为准,不能把公共 API 单价直接等同于 IDE 账单。
为什么 Coding Agent 会把成本放大
普通 Chat 请求通常是一进一出;Coding Agent 是一个闭环。它可能先扫描目录,再读取多个文件,生成修改,运行测试,读取失败日志,重新规划,继续编辑,最后进行全量验证。每一步都可能把之前的上下文、工具结果与推理重新带进下一轮。
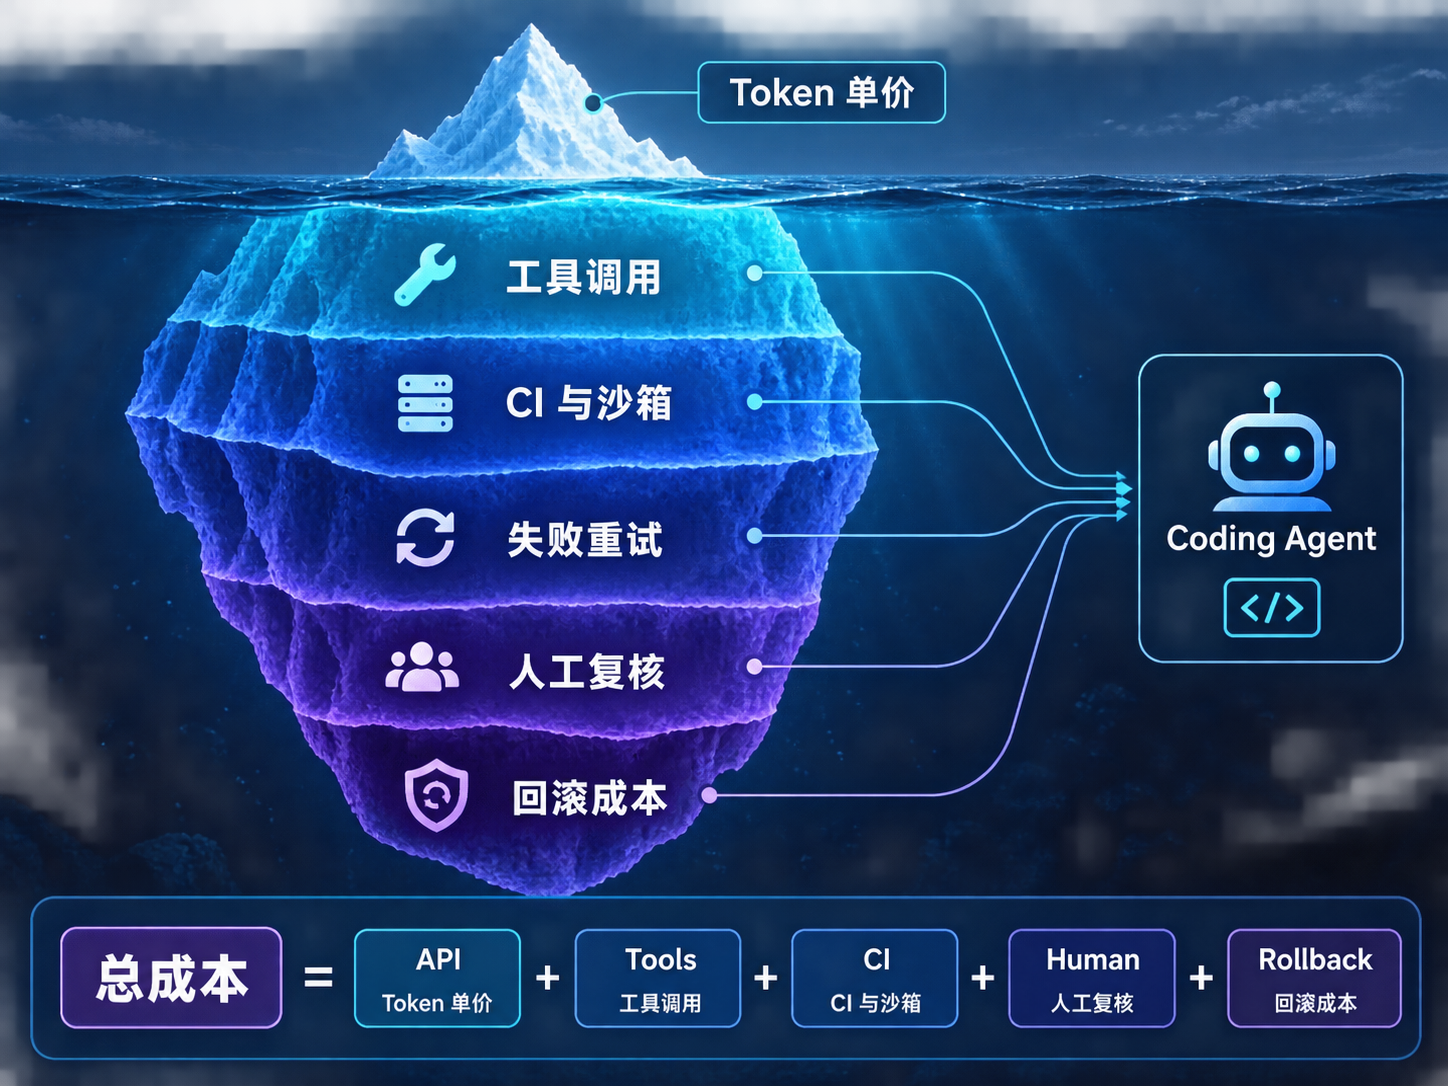
总成本可以拆成:
Agent 总成本 = 模型实际计费
             + 服务端工具调用费
             + 客户端工具与沙箱算力
             + CI/CD 与存储成本
             + 人工复核时间成本
             + 失败重试与回滚成本
在 xAI API 内部,cost_in_usd_ticks 已经覆盖该次请求的 Token、缓存折扣和服务端工具调用,但它不会自动知道你本地 Docker、GitHub Actions、云端测试机、工程师审查和生产回滚花了多少钱。因此,完整成本账本必须把“API 实际计费”和“外部工程成本”合并。
六个最容易漏算的成本放大器
1. 多轮上下文重复传输
登录后阅读全文
以下为核心实操内容。登录或免费注册后,即可查看完整步骤、参数配置、提示词和报错解决方案。
安全、隐私与审计也会影响成本
安全控制看似增加步骤,却能降低事故成本。Coding Agent 会读取 Issue、README、网页、依赖文档和日志,这些内容都可能包含 Prompt Injection。攻击者可能诱导 Agent 搜索敏感文件、读取环境变量、修改 CI 或向外部地址发送代码。
最低治理要求包括:
- API Key 使用密钥管理器并按环境隔离,禁止写入仓库和日志;
- Agent 在临时工作树或容器内运行,默认无生产凭据;
- 网络出口使用域名白名单,上传请求必须经过内容检查;
- Function Calling、MCP 与 Shell 参数在服务端重新校验;
- 付款、发布、删除、邮件、权限、合并和生产数据库写入必须人工批准;
- 所有修改保留 diff、测试证据、成本记录、审批人和回滚点;
- 检测到注入、越权访问或异常工具循环时立即熔断。
xAI 官方安全 FAQ 表示,API 输入和输出默认加密存储 30 天用于审计,不经明确许可不会用于训练;需要更严格处理的团队可以启用团队级 ZDR,但状态化 Responses API、Files、Collections 与 Batch 等依赖存储的能力会受到限制。是否启用 ZDR 需要在隐私、调试能力、缓存/状态续接和运营成本之间权衡。可继续参考 AI Stack Nav 的 Agent 安全沙箱教程 与 Prompt Injection 防护。
重试、超时与常见成本故障
429 表示触达限流,应读取控制台的 RPS、TPM 和团队层级,使用带抖动的指数退避;不要立即并发重试。xAI 的限额按模型设置,并随团队累计消费层级变化,具体额度应以控制台为准。
超时必须分层:模型请求超时、单条 Shell 命令超时、测试套件超时和整个任务墙钟上限不能混为一个数字。长推理请求可以有较长 API 超时,但这不意味着工具可以无限运行。中断后应确认服务端请求是否仍执行,避免重复提交造成双重费用。
常见异常还有:缓存长期为零、日志过大跨越 200K、同一测试失败被反复提交、max_turns 被误当作工具调用总数、Priority Processing 被默认开启,以及美国区域端点的 10% 溢价没有进入预算。最可靠的排查方式是对比 cost_in_usd_ticks、Token 明细、服务端工具使用和本地任务账本。
事实依据与来源
- 官方已确认事实:Grok 4.7 的模型 ID、500K 上下文、短/长上下文价格、200K 阈值、缓存价、服务端工具价格、Priority 与区域端点溢价均来自 xAI 官方文档。
- 官方成本字段:
cost_in_usd_ticks是 xAI 返回的单请求实际计费金额,包含适用折扣、Token 与服务端工具调用;1 美元等于 100 亿 ticks。 - 官方使用字段:缓存 Token、推理 Token、成功服务端工具使用和尝试工具调用来自 xAI API 使用明细文档。
- 合成测试样本:文中 S/M/L 表格是用于演示成本账本的合成数据,人工与 CI 单价是假设,不代表 xAI 官方测试或真实客户账单。
- 编辑判断:CPAT、120K~160K 主动压缩区间、三档任务和多维熔断是工程实施建议,需要在真实仓库验证。
- 尚需实测:具体编码成功率、延迟、缓存命中、工具数量、人工复核时间、地区可用性和套餐账单以实际项目和控制台为准。
- 内容核验日期:2026 年 09 月 23 日。
FAQ
Grok 4.7 当前 API Token 价格是多少?
全球端点短上下文为输入 2 美元、缓存输入 0.50 美元、输出 6 美元/百万 Token。提示词达到 200K 后,长上下文为输入 4 美元、缓存输入 1 美元、输出 12 美元/百万 Token。价格可能调整,部署前应再次检查官方价格页。
推理 Token 会收费吗?
会。xAI 官方文档说明 reasoning tokens 按完整输出 Token 费率计费。不要只根据可见回答字数估算费用,应读取 output_tokens_details.reasoning_tokens 和 cost_in_usd_ticks。
cost_in_usd_ticks 是否已经包含工具费用?
是。官方成本追踪说明该字段是单请求实际计费,包含缓存折扣后的 Token 成本和服务端工具调用成本。它不包含你自己的本地 Shell、第三方 MCP、CI、云主机和人工复核费用。
为什么缓存很多,仍然触发长上下文价格?
因为长上下文阈值按总提示 Token 判断,其中包括缓存 Token。超过 200K 后,缓存和非缓存 Token 分别使用各自的长上下文费率,因此缓存降低单价但不会阻止阈值触发。
max_turns 能限制工具调用总数吗?
不能完全限制。它限制 Agent 推理循环的轮次,而一轮可能并行调用多个工具。还需要在客户端限制累计工具调用、网络请求、Shell 命令和总费用。
Grok 4.7 Fast 是否值得用于 Coding Agent?
对延迟敏感的交互任务可能值得,但其 Token 价格为标准版两倍,而且只在 Cursor 与 Grok Build 中提供。后台批处理和对延迟不敏感的任务通常不应默认使用 Fast。
什么时候应该主动压缩上下文?
不要等到 200K 临界点。建议在 120K~160K 区间根据增长速度触发检索、日志裁剪和状态摘要,并监控压缩后是否丢失关键证据。该区间是实施建议,不是官方硬限制。
哪些错误可以自动重试?
短暂网络故障、部分 5xx 和 429 可使用指数退避重试。代码逻辑错误、测试失败、权限拒绝、Prompt Injection 和预算超限不应原样重试,应重新规划、回滚或转人工。
如何判断 Grok 4.7 对团队是否真的便宜?
使用至少 30 个脱敏历史任务,记录所有尝试成本,并以通过验收的任务数计算 CPAT。再将一次成功率、P95 延迟、人工分钟和回滚率与现有方案对比,而不是只对比每百万 Token 单价。
企业使用是否应开启 ZDR?
只有合规要求明确需要时再开启。ZDR 可以避免请求和响应持久化,但会禁用或限制依赖存储的功能。启用前应验证状态续接、Files、Collections、Batch、审计和故障排查流程是否仍满足业务要求。
参考来源
- xAI 官方 API Pricing
- xAI 官方 Models & Pricing
- xAI 官方 Cost Tracking
- xAI 官方 Prompt Caching Usage & Pricing
- xAI 官方 Tool Usage Details
- xAI 官方 Rate Limits
- xAI 官方 API Security FAQ
内容核验日期:2026 年 09 月 23 日
会员充值与订阅排查资料
适合阅读会员充值、订阅购买、权益对比和支付问题类文章后继续转化。
