
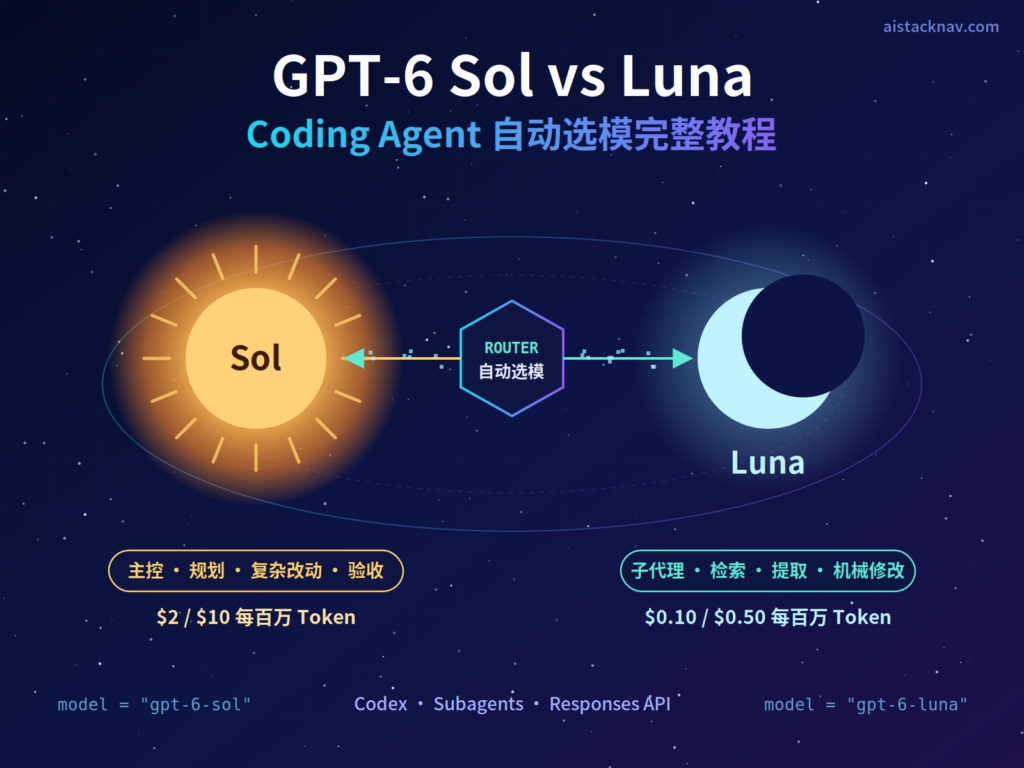
摘要: 本文讨论 OpenAI 于 2026 年 9 月 22 日发布的 GPT‑6 Sol 与 GPT‑6 Luna,在 Coding Agent(以 Codex 和 OpenAI API 为主)中应该如何分工、如何让系统“自动选模”。核心结论是:主控与复杂改动交给 Sol,代码检索、信息提取、机械修改等边界清晰的子任务交给 Luna,并用“固定模型的自定义子代理 + 失败自动升级”来实现自动选模,而不是指望 Agent 自己猜。本文适合已经在用 Codex、Cursor 类工具或自建 Agent 的开发者与团队。两款模型已 GA,建议现在就在非生产分支上迁移测试;读完后你能拿到可直接复制的 config.toml、自定义子代理文件、一个 Python 自动路由器,以及一套成本估算方法。
核心结论
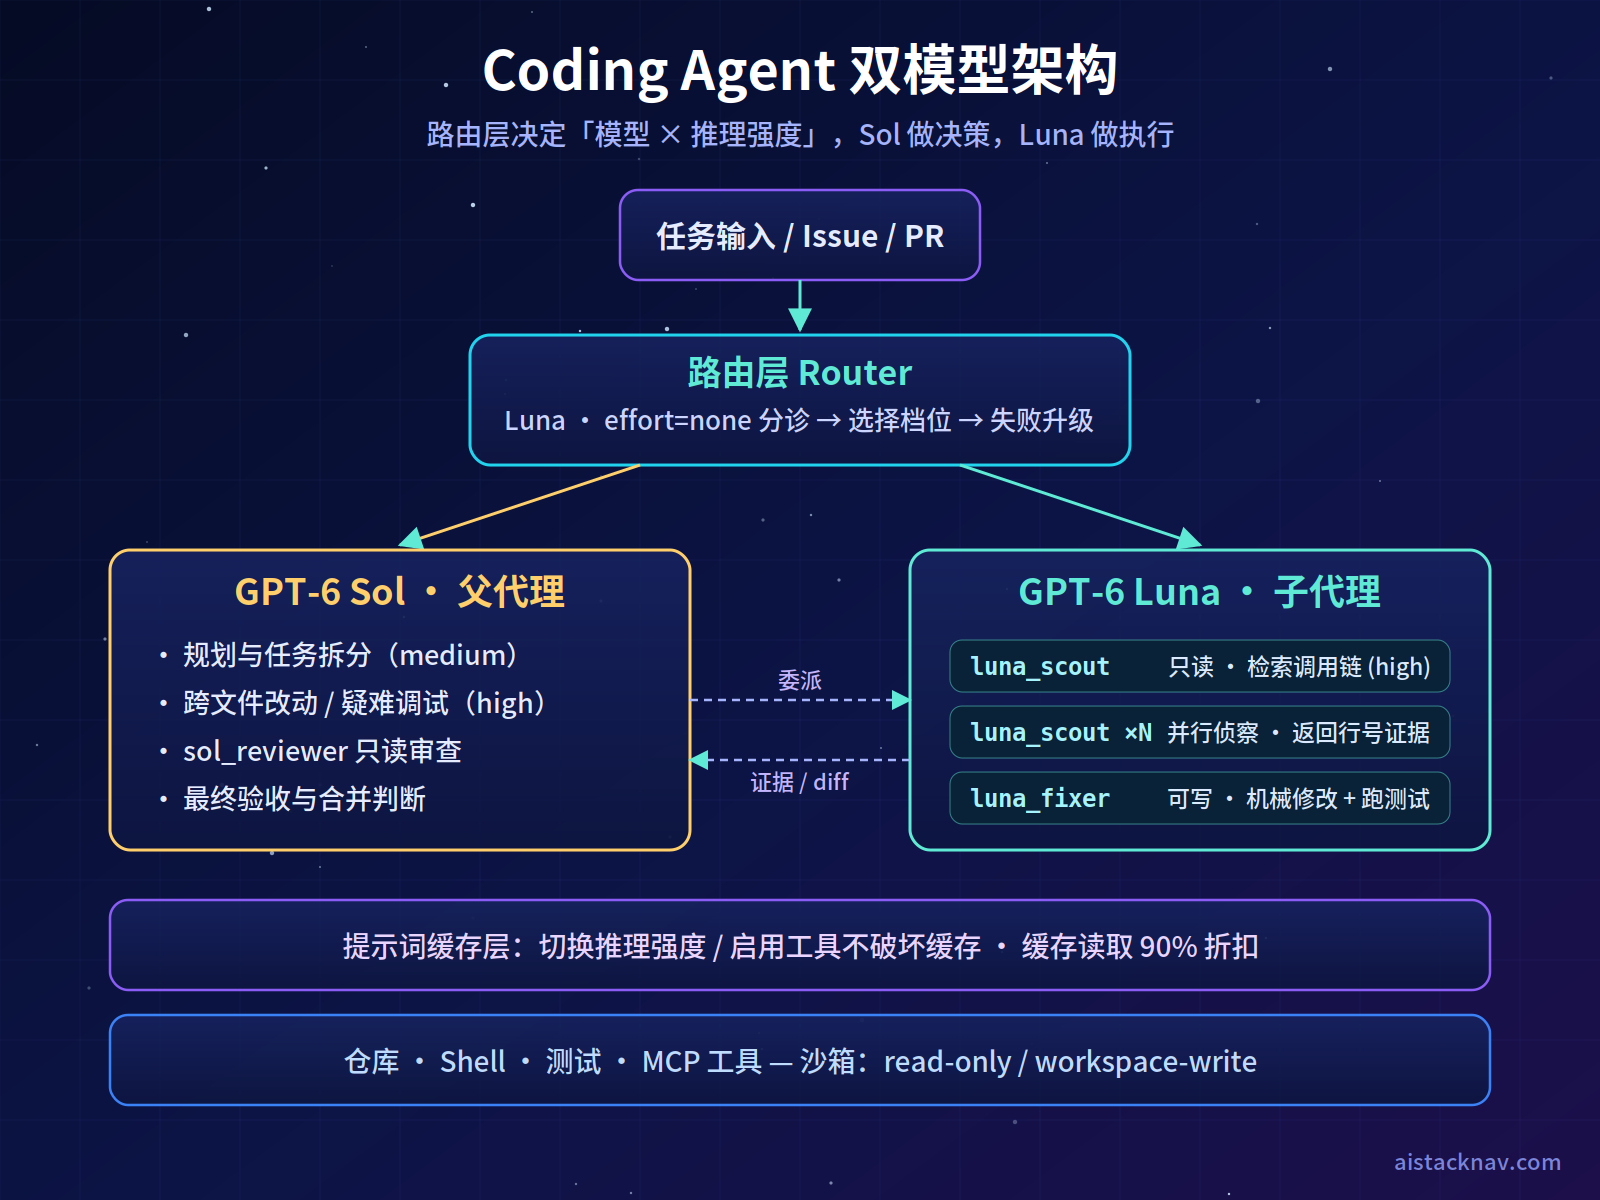
GPT‑6 Sol 和 Luna 不是“二选一”,而是一主一辅:在 Coding Agent 里,Sol 负责规划、跨文件改动、调试和最终验收,Luna 负责大批量、目标明确的子任务。“自动选模”最可靠的做法是把选择规则写进配置和代码——在 Codex 中用固定了 model 与 model_reasoning_effort 的自定义子代理,在 API 中用“Luna 分诊 → 按难度路由 → 测试失败就升级到 Sol”的路由器。
- 价格差距约 20 倍:官方 API 价格 Sol 为输入 $2 / 输出 $10(每百万 Token),Luna 为 $0.10 / $0.50,均比 GPT‑5.6 对应型号便宜 50%。把能下放的子任务交给 Luna,是最直接的降本手段。
- 起步参数:官方在 Codex 中建议 Sol 从 Medium 起步、Luna 从 High 起步;Luna 最高支持 Max,但不支持 Ultra。
- 最大的坑是“子代理继承父模型”:官方文档说明,未配置模型的子代理会继承父代理的模型和推理强度。开着 Sol Ultra 却不配置子代理,等于所有子任务都在跑 Sol,额度消耗会非常快。
- API 接入优先用 Responses API:官方迁移指南说明,Sol 与 Luna 在 Chat Completions 中只有
reasoning_effort: "none"时才支持函数调用,带推理的工具调用请用 Responses API。 - 实施建议:先让 Luna 承担只读类子代理(检索、摘要、测试日志分析),跑一两周对比质量与账单,再逐步放开可写权限。
背景与主要变化
先说结论:这次更新的重点不是能力大跃进,而是“同等能力更便宜、缓存更省”,这恰好让“多模型分工”的 Coding Agent 架构第一次变得非常划算。
OpenAI 在本月早些时候发布了旗舰模型 GPT‑6 Astra,随后于 9 月 22 日(美国时间)推出 GPT‑6 Sol 和 GPT‑6 Luna。官方表示两者采用与 Astra 相近的训练方法,把 Astra 在专业工作、事实准确性、编程、计算机操作和对齐上的进展带到更快、更便宜的模型中。第三方媒体 heise 的评价则更冷静:价格显著下降,但代际性能跃升并不明显。这两种说法并不矛盾——对 Agent 开发者而言,价格和缓存才是这次最值得利用的变化。
| 项目 | GPT‑6 Sol | GPT‑6 Luna | 说明 |
|---|---|---|---|
| API 模型 ID | gpt-6-sol |
gpt-6-luna |
官方公告确认 |
| 输入价格(每百万 Token) | $2(原 GPT‑5.6 Sol $4) | $0.10(原 $0.20) | 官方公告 |
| 输出价格(每百万 Token) | $10(原 $20) | $0.50(原 $1.20) | 官方公告 |
| 缓存输入读取 | 官方称 GPT‑6 缓存读取享 90% 折扣 | 同左 | 具体单价以官方定价页为准 |
| 上下文窗口 | 1,050,000 Token | 1,050,000 Token | 来自 LiteLLM 与第三方模型库,建议以模型页复核 |
| 最大输出 | 128,000 Token | 128,000 Token | 同上 |
| 推理强度 | none / low / medium / high / xhigh / max | none 至 max | Luna 在 Codex 中不支持 Ultra |
| Codex 可用性 | Plus、Pro、Business、Enterprise、Edu | 同左;Free 和 Go 用户可在桌面端使用 Luna | 官方公告 |
另一个与 Coding Agent 直接相关的时间点是:GPT‑5.5 将于 2026 年 10 月 14 日从 ChatGPT、ChatGPT Work 和 Codex 中下线(API 不受影响)。官方要求用户替换工作区默认值、自定义代理、定时任务和脚本中的 gpt-5.5。如果你的 ~/.codex/agents/ 目录里还写着旧模型名,现在就是统一改造的时机。更多 Codex 相关教程可以在 AI Stack Nav 的 Codex 专题搜索 中找到。
需要注意的边界:长上下文(超过 272K Token)的请求在 LiteLLM 文档中被列为单独计价档位,具体价格官方公告未写明,接入前请在 OpenAI 定价页确认。
核心功能拆解
结论先行:理解 Sol/Luna 的差异只需要看三件事——模型定位、推理强度、API 调用方式;Coding Agent 的“自动选模”就是在这三者之间做组合。
模型定位:主控与工人
官方在 Codex 模型页中的定位非常清楚:Sol 适合日常工作和复杂编程,尤其是模糊、困难或高价值的任务;Luna 适合“你已经知道好结果长什么样”的高频任务,例如提取、分类、转换和结构化摘要。Astra 则留给需要最强能力、跨多个步骤与工具的端到端工作。
放到 Coding Agent 里,可以翻译成下面这条编辑判断(非官方结论):凡是需要“做决定”的步骤给 Sol,凡是“按规格执行并返回证据”的步骤给 Luna。 例如“这个 Bug 的根因是什么、该改哪几处”是决定;“列出所有调用 parseConfig 的文件和行号”是执行。
推理强度:同一模型的第二个旋钮
两款模型都支持从 none 到 max 的推理强度,API 默认值为 medium。在 Codex 桌面端和 CLI 中,官方给出的起点是 Sol 用 Medium、Luna 用 High,并提醒不同代际之间的推理档位并不能一一对应。
这意味着“自动选模”其实是一个二维选择:模型 × 推理强度。一个常见误区是用 Sol + low 做简单任务——你付的是 Sol 的单价,却只用了很浅的推理。更合理的组合是:简单分类用 Luna + none,中等检索用 Luna + high,复杂改动用 Sol + medium,疑难调试用 Sol + high 或 xhigh。
官方还特别说明 Max 与 Ultra 的区别:Max 是让单个模型对一个任务思考更久;Ultra 则会使用子代理并行处理复杂任务的不同部分。大多数任务既不需要 Max 也不需要 Ultra。
API 调用方式:优先 Responses API
根据 OpenAI 的 GPT‑6 迁移指南,有三条规则直接影响 Agent 代码:
- Sol 与 Luna 支持
none推理强度,Astra 不支持(Astra 最低用low)。 - 在 Chat Completions 中,Sol 与 Luna 只有在
reasoning_effort: "none"时才支持函数调用;需要“推理 + 工具”时应使用 Responses API。 - 推理强度不为
none时,需要移除temperature、top_p、top_logprobs等参数。
此外,官方这次改进了提示词缓存:调整推理强度或启用/禁用工具,不再破坏之前上下文的缓存复用,并新增了显式缓存断点。对于在同一个长会话里频繁切换“轻任务/重任务”的 Agent,这是实打实的省钱点。
适用人群与使用场景
结论:个人开发者最该做的是“配置子代理”,团队最该做的是“把选模规则写进仓库”,平台型团队最该做的是“在 API 层建路由器”。
原因在于三类用户的瓶颈不同。个人开发者的问题通常是 Codex 额度消耗太快;团队的问题是每个人的模型配置不一致,导致成本和质量都不可预期;而自建 Agent 平台的团队需要按请求粒度控制成本。
| 场景 | 推荐模型与强度 | 理由(编辑判断) |
|---|---|---|
| 仓库检索、定位调用链 | Luna / high,只读 | 目标明确,结果可用行号验证 |
| 测试日志、CI 失败摘要 | Luna / medium | 典型的提取与摘要任务 |
| 批量重命名、格式迁移、样板代码 | Luna / high,可写 | 规则清晰,但需要测试兜底 |
| 跨模块功能开发、重构 | Sol / medium | 需要判断与权衡 |
| 疑难 Bug、并发问题 | Sol / high 或 xhigh | 需要更深推理 |
| PR 最终审查与合并判断 | Sol / high,只读 | 验收权应留在更强模型 |
| 高风险架构决策 | Astra | 官方建议最难的端到端工作使用 Astra |
适用边界:如果你的项目很小、一次任务只改一两个文件,单用 Sol Medium 就够了,拆子代理反而会增加上下文传递和 Token 开销——官方文档也提醒子代理工作流比单代理消耗更多 Token。
安装、配置或使用步骤
结论:Codex 用户按下面 7 步配置即可获得“Sol 主控 + Luna 子代理”的固定分工;自建 Agent 的读者可以直接跳到后面的 Python 路由器。
在 Codex 中配置自动分工
- 升级客户端:确保 Codex CLI、IDE 插件或桌面端为最新版本,然后执行
codex --model gpt-6-sol确认账号可以使用新模型。Enterprise 与 Edu 工作区需要管理员先启用 Luna。 - 设置父代理默认模型:编辑
~/.codex/config.toml(或仓库根目录的.codex/config.toml,便于团队统一)。 - 限制并发与嵌套:在
[agents]中设置max_threads与max_depth。官方默认值分别是 6 和 1,除非确实需要递归委派,不要调高max_depth。 - 创建 Luna 只读侦察代理:在
.codex/agents/下新建 TOML 文件,固定模型、推理强度和只读沙箱。 - 创建 Luna 机械修改代理与 Sol 审查代理:让“能写的 Luna”只处理规则明确的改动,让“只读的 Sol”负责审查。
- 重启任务:新增或修改代理文件后,开启一个新的 Codex 任务,让客户端重新发现这些代理。
- 验证实际模型:在 CLI 中用
/agent切换到子代理线程查看其模型与推理强度;同时用codex exec -m gpt-6-luna "echo test"做一次对照运行。确认子代理真的在用 Luna 之后再大规模使用。
父代理配置示例:
# .codex/config.toml(提交到仓库,团队共享)
model = "gpt-6-sol"
model_reasoning_effort = "medium"

[agents]
max_threads = 4   # 控制并发子代理数量,避免额度瞬间耗尽
max_depth = 1     # 只允许一层子代理,防止递归扇出
Luna 只读侦察代理:
# .codex/agents/luna-scout.toml
name = "luna_scout"
description = "只读代码侦察:定位文件、调用链、配置项,返回带行号的证据。"
model = "gpt-6-luna"
model_reasoning_effort = "high"
sandbox_mode = "read-only"
developer_instructions = """
只在父代理给定的范围内工作。
返回:相关文件路径、符号名、行号、以及你不确定的点。
不要提出修复方案,不要修改文件。遇到重大歧义立即停止并报告。
"""
nickname_candidates = ["Scout-A", "Scout-B", "Scout-C"]
Luna 机械修改代理与 Sol 审查代理:
# .codex/agents/luna-fixer.toml
name = "luna_fixer"
description = "按明确规格执行机械修改:重命名、格式迁移、补充样板代码。"
model = "gpt-6-luna"
model_reasoning_effort = "high"
sandbox_mode = "workspace-write"
developer_instructions = """
只执行父代理给出的明确修改清单,不做架构调整。
每次修改后运行指定测试命令,并返回 diff 摘要与测试结果。
规格不清晰时停止,不要自行猜测。
"""
# .codex/agents/sol-reviewer.toml
name = "sol_reviewer"
description = "最终审查:正确性、安全、回归风险、测试缺口。"
model = "gpt-6-sol"
model_reasoning_effort = "high"
sandbox_mode = "read-only"
developer_instructions = """
像代码负责人一样审查。优先报告正确性、安全和行为回归问题,
给出可复现步骤;不要只提风格问题。
"""
注意边界:官方文档说明,Codex 会在生成子代理时重新应用父会话的实时覆盖设置,包括你在会话中通过 /permissions 或 --yolo 设定的沙箱与审批选项——即使代理文件写了 read-only。所以不要在开着 --yolo 的会话里依赖代理文件的沙箱设置。
在 API 中实现自动路由
如果你在自建 Agent(或者用 n8n、Dify 调用 OpenAI API),可以用下面这个最小路由器:先用 Luna(none 推理)做分诊,再按难度选择模型,执行后跑测试,失败就升级。
# router.py —— 最小可用的 Sol / Luna 自动选模路由器
import json, os, subprocess
from openai import OpenAI

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])  # 从环境变量读取,勿硬编码

TIERS = [
    ("gpt-6-luna", "high"),    # 第 1 档:便宜,适合边界清晰任务
    ("gpt-6-sol", "medium"),   # 第 2 档:默认主力
    ("gpt-6-sol", "high"),     # 第 3 档:疑难问题
]

def triage(task: str) -> int:
    """用 Luna + none 推理做分诊,返回起始档位 0/1/2。"""
    resp = client.responses.create(
        model="gpt-6-luna",
        reasoning={"effort": "none"},
        input=(
            "判断以下编码任务的难度,只输出 JSON:"
            '{"tier":0|1|2,"reason":"..."}。'
            "0=检索/提取/机械修改;1=普通功能或多文件改动;2=疑难调试/并发/架构。\n\n"
            f"任务:{task}"
        ),
    )
    try:
        return int(json.loads(resp.output_text)["tier"])
    except (ValueError, KeyError, json.JSONDecodeError):
        return 1  # 解析失败时保守地走 Sol

def run_tests() -> bool:
    r = subprocess.run(["pytest", "-q"], capture_output=True, timeout=600)
    return r.returncode == 0

def solve(task: str, context: str, max_escalations: int = 2) -> dict:
    tier = triage(task)
    for attempt in range(max_escalations + 1):
        model, effort = TIERS[min(tier, len(TIERS) - 1)]
        resp = client.responses.create(
            model=model,
            reasoning={"effort": effort},
            instructions="你是代码修改代理。只输出 unified diff。",
            input=f"{context}\n\n任务:{task}",
        )
        patch = resp.output_text
        # apply_patch(patch)  # 在隔离工作区应用补丁,此处省略
        if run_tests():
            return {"model": model, "effort": effort, "attempts": attempt + 1, "patch": patch}
        tier += 1  # 测试失败 → 升级
    return {"status": "needs_human", "last_model": model}
这个路由器的关键设计有三点:分诊本身用最便宜的 Luna + none;升级依据是客观的测试结果而不是模型自评;设置 max_escalations 上限防止无限循环。生产环境还需要补上超时、重试退避、补丁应用的隔离目录以及调用日志。
实际工作流示例
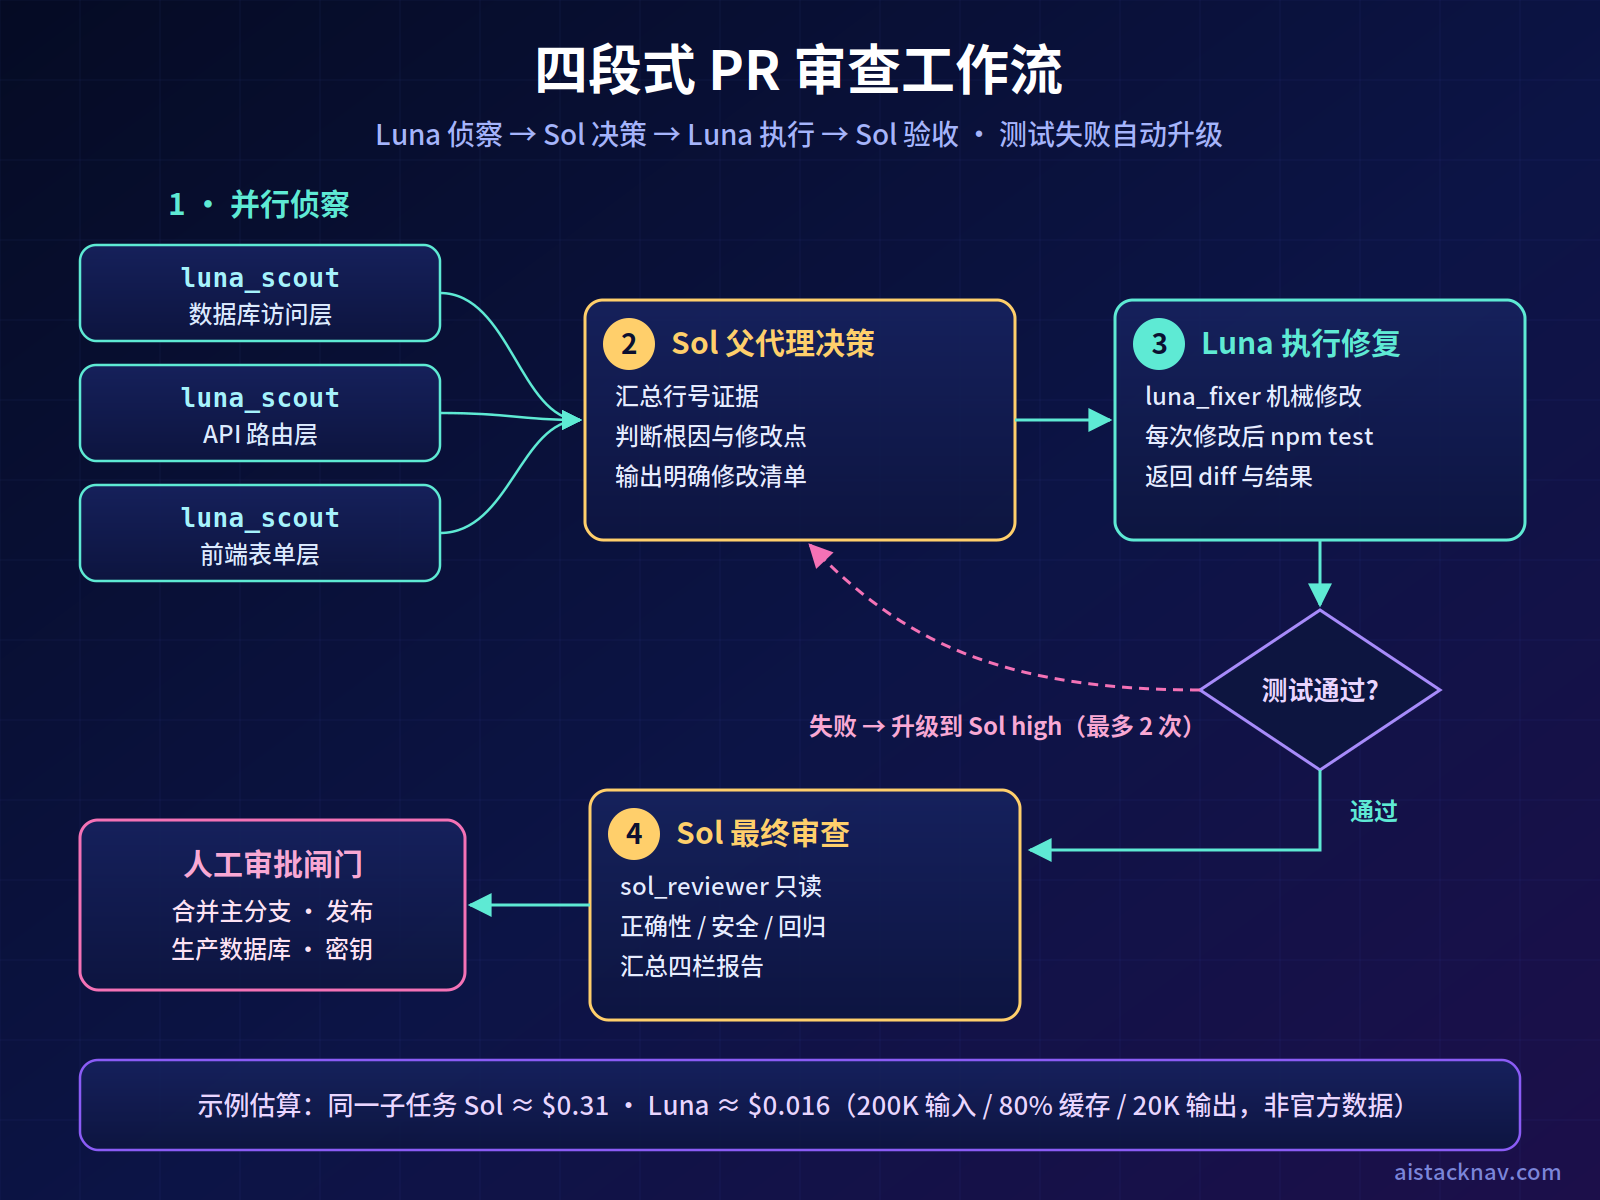
结论:一个典型的“PR 审查 + 修复”任务,按“Luna 侦察 → Sol 决策 → Luna 执行 → Sol 验收”四段拆分,能把大部分 Token 消耗压到 Luna 上,同时让关键判断留在 Sol。
工作流:并行审查一个功能分支
在已完成上面配置的仓库里,对 Codex 发出这样的提示:
审查当前分支相对 main 的改动。
1. 让 luna_scout 并行启动 3 个实例,分别梳理:数据库访问层、API 路由层、前端表单层 的受影响代码,返回带行号的证据。
2. 你(父代理)汇总证据,判断需要修改的点,写出明确的修改清单。
3. 修改清单中属于重命名、补充类型注解、补测试样板的部分交给 luna_fixer,每次修改后运行 npm test。
4. 所有修改完成后,让 sol_reviewer 做最终审查。
5. 等待全部子代理结束,按“问题 / 证据 / 已修复 / 待人工确认”四栏汇总。
这里的“自动”体现在:父代理只负责决定“谁做什么”,而“用什么模型”已经被代理文件固定,不依赖父代理临场判断。
成本估算(示例计算,非官方数据)
假设某个子任务读取 200K Token 上下文,其中 80% 命中缓存,输出(含推理 Token)20K。按官方公布的价格和 90% 缓存折扣推算:
- Sol:新鲜输入 40K × $2/M = $0.080;缓存输入 160K × $0.20/M = $0.032;输出 20K × $10/M = $0.200;合计约 $0.31。
- Luna:新鲜输入 40K × $0.10/M = $0.004;缓存输入 160K × $0.01/M ≈ $0.0016;输出 20K × $0.50/M = $0.010;合计约 $0.016。
同样的子任务,Luna 大约是 Sol 的二十分之一。如果一次审查拆出 3 个侦察子代理,全部用 Sol 约 $0.93,全部用 Luna 约 $0.05。真实账单取决于推理 Token 数量、缓存命中率和是否超过 272K 长上下文档位,请以控制台用量为准。使用 ChatGPT 账号登录 Codex 时,消耗计入套餐额度而不是 API 账单,但相对比例思路相同。
对比与选型建议
结论:默认用 Sol 做主控;只有在任务能被“写清楚验收标准”时才下放给 Luna;Astra 只留给少数高价值、端到端的难题。
以下是官方公布的部分编程相关成绩(均为 OpenAI 官方测试,且对比对象成绩取自公开报告,并非独立第三方复现):
- DeepSWE v1.1:Sol(max)得分 68.8%,官方称与 Claude Fable 5 的最高成绩相差 1.1 个百分点,每任务成本约低 80%;Luna(max)为 66.6%。
- AutomationBench:Sol(xhigh)得分 33.2%,每任务成本 $0.27;Luna(high)比上一代提升 5.4 个百分点。
- FrontierCode 1.1:官方称 Sol 相较 GPT‑5.6 Sol 有明显提升,并以更低成本达到 Claude Fable 5.1 xhigh 的水平。
编辑判断:Luna 在 max 强度下的 DeepSWE 成绩与 Sol 差距并不大,这说明“Luna + 高推理强度”是一个值得认真评估的档位——但高强度会产生更多推理 Token,单价优势会被部分抵消。选型不应只看榜单,而应该拿自己仓库里 20~50 个历史任务做回放测试,统计“一次通过率 × 单任务成本”。Microsoft 在 Foundry 的发布文章中也强调,合适的模型应通过评测来确定。
如果你在对比其他厂商的编程模型与 Agent 工具,可以参考站内的 AI 编程工具合集,以及 Agent 实战教程。
风险、限制与注意事项
结论:多模型 Agent 的主要风险不是模型能力,而是“配置没生效”“无限扇出”和“权限过大”这三类工程问题。
子代理模型可能没有按预期生效。 官方文档说明未配置的子代理会继承父模型。此外,在 GPT‑5.6 时期,GitHub 上有用户报告自定义代理中写明的 Luna 配置被忽略、子代理实际继承了父代理的 Sol Ultra(openai/codex issue #32587),社区论坛也有类似反馈。这些问题在 GPT‑6 版本中是否已修复,官方目前未明确说明,因此第 7 步的验证不能省略。
Ultra 与自动委派会放大消耗。 Ultra 会主动把工作分给子代理,如果没有配置子代理模型,这些子代理很可能都在高强度运行。官方也明确提醒:子代理工作流比单代理消耗更多 Token,调高 max_depth 可能导致重复扇出。
权限与审批。 可写的子代理只应处理规则明确的修改;涉及删除数据、执行生产数据库操作、推送到主分支、发布版本、修改 CI 密钥等动作,必须保留人工审批。审查类代理一律设为只读,并且不要在 --yolo 会话里依赖代理文件的沙箱设置。
Prompt Injection。 侦察代理会读取仓库中的文档、Issue 和依赖代码,这些内容里可能夹带“忽略之前的指令”之类文本。把侦察代理设为只读、要求其只返回证据而非执行指令,是最基本的隔离手段。
API 侧的工程细节。 路由器需要设置请求超时、带指数退避的重试、每个任务的预算上限,以及对补丁应用的幂等处理(同一补丁重复应用不应产生副作用)。函数调用的参数必须在服务端再校验一遍,不能直接信任模型输出。所有调用应记录模型、推理强度、Token 数和结果,便于审计与成本复盘。
模型与客户端变动。 Codex 自定义代理的文件格式官方表示“可能随着编写与分享能力成熟而演进”;GPT‑5.6 系列在迁移期仍可用,但下线时间以官方公告为准。建议把模型名集中写在仓库级配置中,方便一次性替换。
事实依据与来源
官方已确认的事实: GPT‑6 Sol 与 Luna 的发布、API 模型 ID(gpt-6-sol、gpt-6-luna)、API 价格及相对 GPT‑5.6 降价 50%、缓存读取 90% 折扣、Codex 与 ChatGPT Work 的可用套餐,均来自 OpenAI 官方公告。推理强度档位与 Chat Completions 函数调用限制来自 OpenAI API 模型页与 GPT‑6 迁移指南。子代理继承父模型、max_threads/max_depth 默认值、自定义代理文件字段、Sol Medium / Luna High 起步建议、Luna 不支持 Ultra、GPT‑5.5 于 10 月 14 日下线,来自 Codex 官方文档。
官方 Benchmark: DeepSWE、AutomationBench、FrontierCode 等成绩均为 OpenAI 公布,竞品成绩由 OpenAI 引用公开报告,本文未独立复现。
第三方资料: 1,050,000 Token 上下文与 128K 输出、272K 长上下文分档来自 LiteLLM 文档与第三方模型库;子代理模型未生效的问题来自 GitHub Issue 与 OpenAI 开发者社区用户报告;“性能跃升有限”的评价来自 heise。
编辑判断与实施建议: “决定给 Sol、执行给 Luna”的分工原则、场景推荐表、三个代理文件、Python 路由器和四段式工作流,均为本文实施建议,需要在你的项目中实测验证。成本估算为按公开价格推算的示例,不代表实际账单。
内容核验日期: 2026 年 9 月 25 日。
FAQ
GPT‑6 Sol 和 GPT‑6 Luna 的 API 模型 ID 是什么?
API 中分别使用 gpt-6-sol 和 gpt-6-luna。在 Codex CLI 中可以用 codex --model gpt-6-sol 或 codex -m gpt-6-luna 指定,也可以在 config.toml 中写 model = "gpt-6-sol" 作为默认值。Enterprise 和 Edu 工作区需要管理员先启用 Luna。
Sol 和 Luna 的价格分别是多少?
按 OpenAI 官方公告,Sol 为每百万输入 Token $2、输出 $10;Luna 为每百万输入 $0.10、输出 $0.50,两者都比 GPT‑5.6 对应型号便宜 50%,且缓存输入读取享 90% 折扣。超过 272K Token 的长上下文请求可能有单独价格,请以官方定价页为准。
Coding Agent 应该默认用 Sol 还是 Luna?
默认用 Sol(Medium)作为主控代理。官方在 Codex 子代理文档中也建议大多数任务从 gpt-6-sol 开始,把 gpt-6-luna 用于更快、更便宜的轻量子代理工作。只有当任务的验收标准能写清楚、并且可以用测试或行号证据验证时,才适合整体交给 Luna。
为什么我配置了 Luna 子代理,额度还是消耗得很快?
最常见的原因是子代理实际继承了父代理的模型。官方文档说明未配置模型的子代理会继承父模型;此外 GPT‑5.6 时期有用户报告自定义代理配置未生效的问题。请在 CLI 中用 /agent 查看子代理实际模型,确认新增代理文件后已开启新任务,并避免在 Ultra 模式下不加配置地让模型自动委派。
Luna 能用 Ultra 模式吗?
不能。Codex 官方模型页说明 GPT‑6 Luna 支持的推理强度最高到 Max,但不支持 Ultra。Ultra 是基于子代理的并行委派模式,适合可以拆分的大任务;如果你需要并行,可以用 Sol 作为父代理,把子代理固定为 Luna。
用 Chat Completions 接口调用 Sol,函数调用为什么报错或不生效?
根据官方 GPT‑6 迁移指南,Sol 与 Luna 在 Chat Completions 中只有在 reasoning_effort 为 none 时才支持函数调用。如果你需要“推理 + 工具调用”,应迁移到 Responses API。另外,推理强度不为 none 时要移除 temperature 和 top_p 参数。
从 GPT‑5.5 或 GPT‑5.6 迁移过来需要改哪些地方?
需要替换工作区默认模型、config.toml、.codex/agents/ 下的自定义代理、定时任务和脚本中的旧模型名。官方建议付费套餐改用 gpt-6-sol,Free 和 Go 用户在桌面端改用 gpt-6-luna。推理强度不能直接照搬,建议用几个熟悉的任务从较低档位开始对比。GPT‑5.5 将于 2026 年 10 月 14 日从 Codex 下线。
有没有官方的“自动选模”开关?
官方目前没有一个“自动在 Sol 和 Luna 之间切换”的独立开关。最接近的是 Ultra 模式的自动委派,以及 ChatGPT 桌面端的 Power 预设(从 Luna High 到 Astra Extra High 的六档)。在 Coding Agent 中,更可控的做法是用固定模型的自定义子代理,或在 API 层自己实现分诊与升级路由,本文的配置和代码就是这种方案。
参考来源
- OpenAI:Introducing GPT‑6 Sol and Luna(官方公告)
- OpenAI API:GPT‑6 Sol 模型页
- OpenAI API:GPT‑6 模型迁移指南
- Codex 官方文档:Subagents
- Codex 官方文档:Models
- Microsoft Azure Blog:GPT‑6 Astra、Sol 与 Luna 登陆 Foundry
- AWS Blog:GPT‑6 Sol 与 Luna 登陆 Amazon Bedrock
- LiteLLM:GPT‑6 Sol 与 Luna Day 0 支持(上下文与配置)
- GitHub openai/codex Issue #32587:子代理模型继承问题
- heise online:GPT‑6 Sol and Luna: OpenAI halves prices
内容核验日期:2026 年 09 月 25 日
工具选型与提示词资料
适合阅读工具评测、工具推荐、对比测评类文章后继续转化。
