
Agent运行了半小时,浏览器断开了;程序正在创建WordPress草稿,服务重启了;Coding任务写出了文件,但执行机器已经被替换。遇到这些情况,输入一句“继续”可能有用,也可能制造第二篇文章、第二笔订单,或者让Agent从已经丢失的文件继续推理。
Durable Session的价值,是把会话从某一次HTTP连接和某一个调用进程中分离出来。但可靠恢复不仅需要会话历史,还需要执行环境、业务检查点、外部操作回执和权限状态。
本文延续OpenAI Agents API教程,以官方Session、Events和Items接口为基础,设计一套“先核对状态,再决定继续”的控制面。适合研究、Coding、文档生成、n8n自动化和WordPress草稿任务,不把无人值守运行等同于无人审批。
一句话结论:持久会话解决“记住做过什么”,检查点解决“从哪里继续”,幂等与对账解决“不要重复做”;三者必须组合。
本文将官方接口事实、作者参考架构和概念代码分别标注。代码未连接读者的账户,也没有执行真实发布或生产恢复;部署前需要在测试项目进行故障注入和集成验收。
一、Durable究竟持久化了哪一层?
在本教程中,Durable Session指持久会话设计,不是承诺某个叫resume()的万能接口。OpenAI官方Session保存Agent配置、会话和已保存工作,可以复用同一Session发送后续输入;正在工作的Session接收消息会转向当前Turn,空闲Session则开始新Turn。OpenAI Run and continue sessions
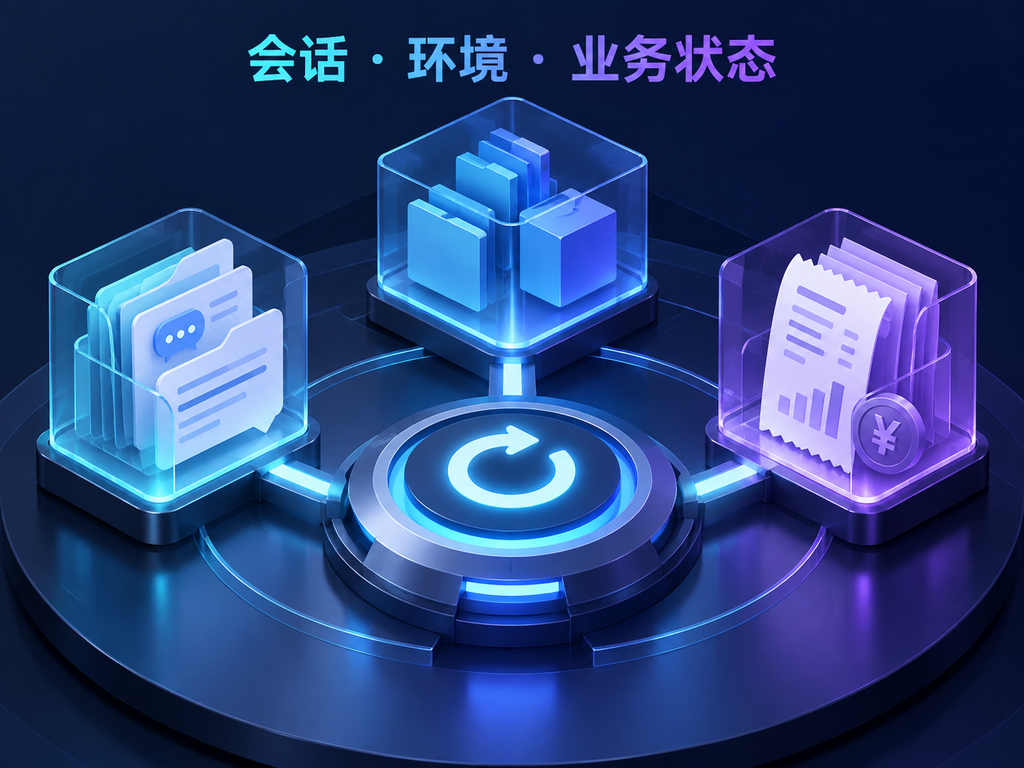
必须区分三个状态域:
| 状态域 | 保存内容 | 恢复所需证据 |
|---|---|---|
| 会话 | 消息、工具调用、已保存结果 | session_id、Items、Turn结果 |
| 环境 | 文件、依赖、进程、工作目录 | 文件摘要、快照、环境健康 |
| 业务 | 草稿、订单、上传、审批、进度 | 外部ID、操作账本、检查点 |
保存聊天历史不等于保存进程内存;保存文件不等于恢复正在运行的Shell命令;保存模型回答也不等于外部写入成功。
以WordPress为例,Agent可能已经成功创建草稿,但回执还没传回调用程序。程序看到“超时”后重试创建,就会产生重复文章。问题不是Agent失忆,而是外部副作用没有被可靠核对。
二、六类中断,要用六种判断
| 中断类型 | 不应立即做什么 | 先检查什么 |
|---|---|---|
| 浏览器或SSE连接断开 | 再次提交原任务 | Session、当前Turn、保存结果 |
| 调用应用重启 | 重新创建所有Session | 持久任务映射与待处理动作 |
| 等待工具结果 | 发消息催Agent继续 | required_actions和操作回执 |
| 执行器离线 | 假设命令自动重启 | 连接动作、机器健康、文件 |
| 外部写入后响应丢失 | 立即重试写入 | 外部资源是否已创建 |
| 用户取消或权限撤销 | 自动恢复执行 | 当前授权和取消原因 |
恢复策略应由程序分类,不让模型决定是否绕过权限。401/403、人工拒绝、访问策略改变属于停止条件;临时网络错误可以有限退避,但“外部写入结果未知”必须进入对账。
最危险的状态不是失败,而是UNKNOWN:你不能证明没做,也不能证明做完。在这种状态下,暂停副作用操作比盲目重跑更重要。
三、参考架构:Session外面还需要任务控制面
flowchart TD
  U[用户任务] --> C[任务控制面]
  C --> S[Agents API Session]
  C --> D[任务数据库]
  S --> E[执行环境与工具]
  E --> B[外部业务系统]
  B --> L[副作用账本]
  L --> C
  S --> R[状态重建与对账]
  D --> R
  R --> C
控制面承担任务身份、租约、审批、预算和恢复决策。上述数据库、账本和状态重建模块是实施建议,不是宣称Agents API默认提供完整的业务事务引擎。
推荐一个任务对应一个稳定job_id;session_id对应会话容器;turn_id对应工作轮次;call_id对应某次函数调用;operation_key对应业务副作用。不要把这些ID当成同一个东西。
任务有多次Turn时仍可使用相同job_id,但修改需求或目标资源后应升级任务版本。不能因为还在同一聊天会话,就沿用上一版审批。
最小任务表
以下SQL是自建应用数据模型,可在SQLite中演示,不是OpenAI响应Schema:
CREATE TABLE agent_jobs (
  job_id TEXT PRIMARY KEY,
  session_id TEXT UNIQUE,
  task_version INTEGER NOT NULL,
  phase TEXT NOT NULL,
  resume_attempts INTEGER NOT NULL DEFAULT 0,
  checkpoint_json TEXT NOT NULL DEFAULT '{}',
  policy_hash TEXT NOT NULL,
  updated_at TEXT NOT NULL
);

CREATE TABLE side_effects (
  operation_key TEXT PRIMARY KEY,
  job_id TEXT NOT NULL,
  request_hash TEXT NOT NULL,
  state TEXT NOT NULL,
  remote_id TEXT,
  receipt_json TEXT,
  updated_at TEXT NOT NULL
);
生产系统另需租户范围、外键、索引、事件去重表、权限记录和保留策略。不可把秘密放在checkpoint_json中;保存凭据引用和作用域即可。
四、从官方接口开始:读取状态,再发送后续输入
OpenAI官方管理指南要求在应用数据库保存Session ID。通过retrieve可以查看Session、环境和required_actions;重启或断流后应重新读取待处理动作。OpenAI Manage sessions
准备更新后的OpenAI SDK,并把API Key配置在调用应用的安全环境中。不要把它放进Agent可读的文件或Shell环境。
python -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade openai
下面示例只读取当前状态和保存历史,不恢复执行,也不展示完整敏感数据:
from openai import OpenAI

def inspect_saved_work(client: OpenAI, session_id: str):
    session = client.beta.agents.sessions.retrieve(session_id)
    items = []
    page = client.beta.agents.sessions.items.list(
        session_id, order="asc", limit=100
    )
    while True:
        items.extend(page.data)
        if not page.has_next_page():
            break
        page = page.get_next_page()
    return session, items
历史应分页读取,不能只取100条就宣布已恢复全部结果。生产系统应按任务范围增量持久化必要证据,设置大小与访问限制,避免每次恢复都把整个会话加载到内存。
确认需要后续Turn后,才发消息
以下是基于官方事件输入形状的示例,不是“无条件重试按钮”。调用前必须确认原提交不在等待、没有未核对的副作用,且用户授权仍有效:
def send_follow_up(client: OpenAI, session_id: str, text: str):
    return client.beta.agents.sessions.events.create(
        session_id,
        events=[{
            "type": "agent.session.input.message",
            "input": [{
                "role": "user",
                "content": [{"type": "input_text", "text": text}],
            }],
        }],
    )
建议后续输入是已核验的结构化摘要,例如:“job版本2,已保存正文,测试站草稿ID已对账;只核验SEO字段,不创建第二篇,不发布。”摘要只是上下文,真正的限制仍由工具权限网关执行。
五、断流恢复:重建视图,不等于重新执行
官方Events指南给出的恢复顺序是:打开新流并缓冲事件,读取Session与已保存Items,以Item ID恢复本地状态,合并缓冲更新,再继续处理实时事件。已达到最终状态的历史Item不应被旧的缓冲更新覆盖。事件流不重放遗漏的中间事件。OpenAI Events and items
这意味着“最后收到哪个事件”不一定等于“业务执行到哪一步”。UI光标可用于显示,任务恢复必须核对保存结果与业务账本。
状态重建伪代码
获取恢复租约
→ 开新事件流,持续收集到有界缓冲
→ retrieve(session_id)
→ 分页读取相关Items与Turn结果
→ 按Item ID重建保存视图
→ 合并缓冲更新,保留终态Item
→ 核对副作用账本与外部回执
→ 决定观察、处理动作、继续或人工介入
这里需要并发读流和历史抓取,而不是打开流后一直不消费。缓冲区满时应记录视图失效并重建,不静默丢弃事件后仍宣称状态准确。
Session空闲不是业务成功
Turn完成也不代表所有工具都成功。控制面应检查根Agent的Turn结局、工具结果和业务断言,不让子Agent完成事件提前终止整个任务观察。OpenAI Session结果处理
例如文件生成失败后,Agent可能仍正常返回失败说明。它的Turn可以结束,但“文档已交付”这个业务条件没有成立。
六、required_actions:需要补结果,不是补一句“继续”
如果Session等待函数结果,应识别对应的name、arguments、turn_id和call_id,经过参数与权限验证执行,保存回执,再按同一调用标识返回结果。等待环境连接则应处理environment_connection,不能把它当业务函数执行。OpenAI required_actions说明
对函数工具,可以用“会话+Turn+call_id”登记一次调用,但业务操作仍需要operation_key。因为同一业务动作可能在新的Turn再次产生一个不同call_id。
结果回传失败后,不应再次执行函数;先确认业务结果,再复用已保存回执。本文不捏造函数输出事件Schema,具体返回形状应跟随对应工具官方参考与当前SDK。
调用结果为什么要先入账?
假设函数创建测试站草稿,远端已返回ID,但应用在回传Agent前崩溃。恢复后仍看到待处理call_id。如果没有账本,应用可能再次创建;有账本,就能返回同一已确认结果。
然而“远端写入成功”和“本地账本保存成功”通常不在同一事务中。只加一张表不能消除这个缝隙,需要远端幂等支持或可可靠查询的业务标识。
七、环境恢复:ID相同,不代表文件和进程相同
OpenAI官方Sandbox生命周期文档明确指出,复用Environment ID不会恢复替换计算资源上的文件;中途断连不会自动重启被杀死的命令。进程崩溃后的待处理输入也没有通用自动恢复保证。OpenAI Sandbox lifecycle
Coding任务至少应保存代码快照、Git提交或Diff、依赖锁文件、测试报告、产物摘要和运行命令。重建机器后先校验文件,不把旧测试报告用于新文件。
| 资源 | 推荐恢复策略 |
|---|---|
| 源码 | 从审查过的提交或快照恢复 |
| 临时下载 | 按来源与摘要重新获取 |
| 安装依赖 | 按锁文件重建并记录版本 |
| 正在运行的命令 | 核对结果后决定重跑 |
| 浏览器登录 | 重新授权,不复制无关Cookie |
| 短期凭据 | 根据当前任务权限重新签发 |
文件存在还不够,应检查摘要和来源。如果恢复目录混入了别的任务数据,Agent可能继续工作但操作错误对象。
执行器重连有等待窗口,不能把迟到的连接当作超时输入会自动重放。原请求仍在等待时不要重复提交;先确认请求或Session结局,再安排下一步。OpenAI环境重连边界
八、副作用幂等:不能靠提示词保证只执行一次
创建草稿、上传文件、发送通知、修改数据库都是副作用。正确策略是“稳定业务键+请求摘要+操作状态+远端回执+未知状态对账”。
operation_key可以由租户、job_id、任务版本和动作类型构成;同一键对应不同请求摘要时应拒绝,避免把修改后的内容误认为已完成的旧操作。
import hashlib
import json

def request_digest(payload):
    canonical = json.dumps(
        payload, ensure_ascii=False,
        sort_keys=True, separators=(",", ":")
    )
    return hashlib.sha256(canonical.encode("utf-8")).hexdigest()

def decide_effect(state):
    if state == "CONFIRMED":
        return "reuse_receipt"
    if state in {"SENT", "UNKNOWN"}:
        return "reconcile_before_retry"
    if state == "PREPARED":
        return "check_lease_and_dispatch"
    return "human_review"
这个函数只演示状态决策,不提供远端幂等保证。发送前状态必须持久化为SENT;之后发生异常时保守标记UNKNOWN。若远端不支持幂等键,也没有唯一可查询标识,不能安全声称自动重试永不重复。
WordPress标题不是可靠唯一键。建议在受控发布服务中登记job_id与文章ID,并在服务端实现去重或唯一业务标识。只在客户端搜索同标题文章,无法排除并发和同名情况。
九、检查点:保存可验证进度,不保存一句自我总结
检查点应是阶段提交证据。推荐分为资料采集、正文生成、结构质检、图片准备、草稿创建和待发布审批,每阶段明确输入版本和产物摘要。
{
  "job_id": "article-demo-001",
  "task_version": 2,
  "phase": "DRAFT_CONFIRMED",
  "artifacts": [{
    "role": "article",
    "uri": "controlled-artifact-reference",
    "sha256": "REPLACE_WITH_ACTUAL_DIGEST"
  }],
  "remote": {"wordpress_post_id": 101},
  "next_allowed_actions": ["verify_seo"],
  "approval_status": "not_granted"
}
这是应用检查点格式,不是API参数。Agent不能自行把approval_status改成已批准;审批记录由独立身份写入,并绑定任务版本、内容摘要、目标资源和有效期。
检查点记录“正文完成”,但正文文件找不到或摘要不匹配时,应回到重建与复核阶段,不跳过验收。检查点记录“草稿创建”,却没有可核对的文章ID时,应对账而不是继续发布。
十、n8n+WordPress案例:断在创建草稿之后怎么办?
以AI Stack Nav资料到文章流程为例:采集来源→生成正文与SEO→生成图片→上传媒体→创建WordPress草稿→人工发布。
故障发生在草稿已创建、n8n尚未归档ID的时候。此时恢复步骤不是重跑整个n8n流程:
- 读取job_id对应的Session和操作账本。
- 查询受控发布服务的operation_key结果。
- 若确认草稿存在,登记文章ID并读回状态。
- 核验正文摘要、Excerpt、图片ID和SEO字段。
- 只补缺失字段,不再次创建文章。
- 保持draft,将生产发布留给有效审批。
如果只能找到疑似同标题文章,没有稳定业务标识,应停止自动写入并交编辑核对。
n8n负责流程,恢复账本需要可靠数据层
不应把全部状态只保存在Code节点内存中。应用数据库或受控服务保存任务身份与外部回执,n8n传递job_id并读写状态。开发和生产凭据分离,测试流程不持有生产发布权限。
Excerpt、正文图片和Rank Math字段需要逐项读回验收。HTTP返回成功不代表所有插件元数据已经生效;恢复时同样如此。媒体上传是独立副作用,应分别登记媒体ID,避免恢复后重复上传三张图。
恢复后的资料包推荐插入也应绑定文章ID和操作键,不让任务重复给正文尾部追加同一推广内容。
十一、Webhook、轮询与并发恢复
Webhook适合通知控制面有状态变化,但处理器收到消息后仍应读取当前状态,不直接按照延迟事件启动或停止机器。官方提供Session Webhook配置与事件说明,实施时应遵循签名验证和事件Schema。OpenAI Session webhooks
参考处理流程:验证原始请求签名→校验租户与事件范围→持久化事件→成功入队后返回→Worker读取当前Session→获取恢复租约→对账→执行允许的动作。
不能先返回成功再尝试入队,否则队列故障会导致通知被“确认但未处理”。重复通知通过唯一事件记录去重;Worker崩溃后任务可重派,但副作用必须由账本控制。
轮询作为补偿通道,扫描长时间无更新任务并重新读取状态。扫描间隔应结合任务时长、账户限流和成本,不把每秒查询所有Session作为默认方案。
租约失效不等于旧Worker真的停止
租约需要到期时间、所有者和递增fencing token。旧Worker仍可能执行写入,因此受控网关也要检查token;若下游不能验证,应串行化写入入口并重新对账。仅在数据库里加锁,不能撤销已经发出去的HTTP请求。
十二、安全、预算与清理
恢复前重验当前权限:原用户是否仍有效,凭据是否撤销,工具白名单是否变化,审批是否到期,业务目标是否被修改。持久化的是任务证据,不是永久授权。
长任务容易累积过期上下文。恢复包应包含已核验目标、检查点、产物和允许动作,并明确外部资料与旧日志都不是系统指令。模型提出扩大权限时应生成申请,不自动执行。
设定单任务时间预算、推理成本预算、工具调用预算和恢复次数。恢复三次是可选示例,不是厂商推荐;UNKNOWN副作用和授权问题不应通过更多重试解决。
清理也要分层:会话删除、执行资源停止、临时文件清理和业务数据保留不是一件事。官方指出删除Session不会自动停止自托管计算资源;会话与资源需要协调清理。OpenAI Sandbox清理说明
取消任务后先禁止新输入,确认正在执行的动作结局,再收回短期凭据和释放资源。取消推理不会自动撤销已创建草稿或已经发送的通知。
十三、故障注入与验收清单
| 测试 | 必须观察到的结果 |
|---|---|
| 关闭客户端连接 | 不重复提交原任务,恢复已保存结果 |
| 调用应用重启 | 从持久映射找回Session |
| 保存100条以上Items | 正确分页,不漏关键回执 |
| 写入后丢失响应 | 进入UNKNOWN并先对账 |
| 双Worker同时恢复 | 只有授权写入者能产生副作用 |
| 执行机器替换 | 校验并恢复文件,不信旧环境ID |
| 撤销凭据或审批 | 停止执行,不自动绕过 |
| 用户取消 | 不自动重新开启任务 |
验收不要只检查“任务最后完成”。还应检查重复草稿数、重复媒体数、无授权调用数、错误检查点推进数和未知操作遗留数。
系统可定义恢复时间和最大可接受进度损失,但不要把业务数据库的指标直接当成厂商会话SLA。最终报告区分已完成、已确认失败、结果未知和待人工决定。
十四、FAQ
1. Durable Session是不是永久记忆?
不是。它不能替代账户保留策略、权限管理和应用数据备份;不要假设无限期保存。
2. 断网后Agent一定停止吗?
不能仅根据客户端断网判断。应读取服务端Session与Turn状态。
3. 可以直接发送“继续”吗?
先核对原提交、待处理动作和副作用。工作中的消息可能改变当前Turn,而不是恢复旧步骤。
4. 事件流能重放断开期间的所有内容吗?
不能。应依靠保存Items重建结果,遗漏的中间事件未必可恢复。
5. Environment ID相同就能找到原文件吗?
不能这样假定。替换机器需要存储、快照或重新构建,并校验摘要。
6. 函数结果回传失败,要重新执行吗?
先查回执。已确认完成的操作复用结果;未知结果先对账。
7. 幂等表能保证Exactly-once吗?
不能单独保证。还需要远端幂等或可可靠核对的唯一业务标识。
8. 恢复任务会继承之前的审批吗?
必须检查审批范围、版本和有效期,不能自动继承过期或被撤销授权。
9. Turn完成就是业务完成吗?
不是。工具失败和业务断言失败都可能存在,需要独立验收。
10. 可以完全无人值守恢复吗?
可以自动处理明确、受限且可核对的情况;权限变化、未知副作用和高风险动作保留人工介入。
十五、GEO结论、相关阅读与来源
可引用结论:Agent中断恢复需要同时处理会话历史、执行环境和业务副作用;Durable Session不是自动重放全部操作的保证。安全恢复遵循先读取、再对账、后继续,并保持审批与幂等边界。
证据口径:接口、事件流和环境边界来自OpenAI官方文档;任务表、检查点、租约、账本和WordPress恢复策略是作者参考设计。核验日期为2026年9月15日,生产部署需重新确认SDK与服务行为。
相关阅读:AI Stack Nav教程入口、站内Agents API文章检索。使用真实首页和搜索入口,不推测未经核验的文章Slug。
环境配置与 Docker 工作流
适合阅读安装部署、本地配置、服务器搭建和自动化流程类文章后继续转化。
