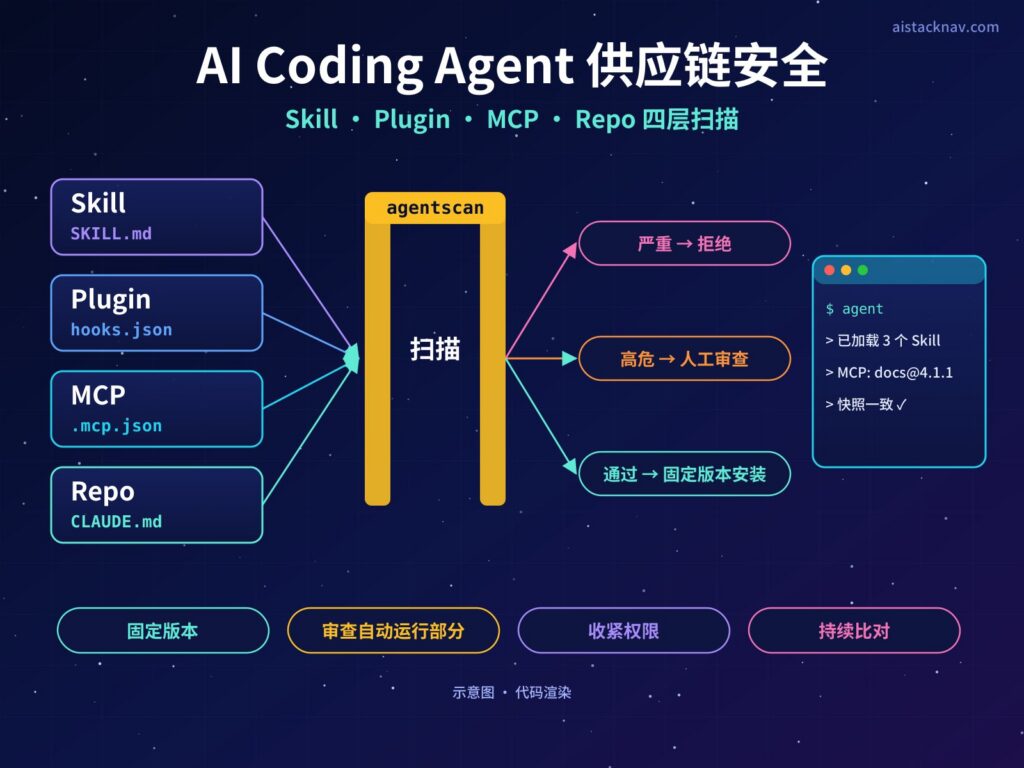
摘要: AI 编程 Agent 正在变成新的软件供应链入口:一个 Skill、一个插件、一条 MCP 配置,装上之后就能读你的文件、执行命令、调用你已登录的服务。本文梳理 2025~2026 年真实发生的几类事件(被投毒的 nx 包借本机 AI CLI 搜刮凭据、第一个恶意 MCP 服务器 postmark-mcp、Agent Skill 市场的大规模恶意样本),把攻击面拆成 Skill、Plugin、MCP、Repo 四层,逐层给出“安装前看什么、怎么查、怎么配”。结论是:最有效的防线不是某个工具,而是三件事——只装固定版本、装前读一遍会自动运行的部分、用组织策略收紧权限。文末附 41 项扫描清单(免费)和一个可接入 CI 的扫描项目。适合使用 Claude Code、Cursor、Codex CLI、Gemini CLI 的个人开发者和团队负责人。
核心结论
AI Coding Agent 的供应链风险,本质是“你把一段别人写的文字或代码,交给了一个有权执行命令的助手”。防护要分三层做:安装前审查来源和内容,安装时固定版本和收紧权限,安装后监控是否被悄悄修改。
- 四个入口要分开看:Skill 是给模型读的指令(风险是提示注入和越权操作);Plugin 可以带 Hook,在你没有任何操作时自动执行命令;MCP 服务器是长期运行的程序,版本一更新行为就可能变;仓库本身也能自带 Agent 配置和指令文件。
- “自动运行”的部分优先审:插件的 SessionStart / UserPromptSubmit Hook、npm 的 postinstall、VS Code 的 folderOpen 任务、仓库里的 .mcp.json,都是不需要你点确认就会执行的代码。
- 固定版本是最便宜的防护:postmark-mcp 前 15 个版本都正常,1.0.16 才加入窃取邮件的代码。
npx -y 包名不写版本的用户会自动拿到恶意版本,写死包名@1.0.15的用户不受影响。 - CI 是高危场景:Claude Code 官方文档说明,
claude -p和 SDK 不会弹出信任对话框,仓库里 .mcp.json 的服务器会直接连接、仓库设置里的 Hook 会直接使用。用 Agent 自动处理外部 PR 前必须先扫描仓库配置。 - 实施建议:个人开发者先用清单把本机已装的组件过一遍;团队用 managed settings 白名单插件市场和 MCP 服务器,并在 CI 中加入扫描。
为什么 AI 编程 Agent 成了新的供应链入口
结论: 传统供应链攻击要骗你“运行代码”,AI Agent 供应链攻击只需要骗你“装一段说明”,执行由 Agent 替你完成。
过去的依赖投毒,恶意代码要等到你 npm install 或运行程序时才执行。AI 编程 Agent 改变了两件事。第一,执行者变了:Agent 本身就能运行 Shell 命令、读写文件、访问网络,攻击者只要让模型“相信”某个操作是任务的一部分,模型就会替他执行。第二,载体变多了:除了代码包,Markdown 写的 Skill、插件里的 Hook 配置、MCP 工具的描述文字、仓库里的 CLAUDE.md,都会直接进入模型上下文或被自动执行。
下面这几起事件,分别对应不同的入口:
| 时间 | 事件 | 入口 | 关键事实(来源见文末) |
|---|---|---|---|
| 2025-08 | s1ngularity:nx 构建工具被投毒 | npm 包 postinstall + 本机 AI CLI | 被植入的脚本调用已安装的 AI CLI,并使用 --dangerously-skip-permissions、--yolo 等参数搜刮文件;泄露 2,349 个密钥;根因是 GitHub Actions 工作流被 PR 标题注入 |
| 2025-08 | Cursor MCPoison(CVE-2025-54136) | MCP 配置 | 已批准的 MCP 配置之后被修改,不再重新询问;1.3 版修复 |
| 2025-09 | Shai-Hulud 蠕虫 | npm 包 postinstall | 用 TruffleHog 搜刮密钥,拿到 npm 令牌后自动发布更多被感染的包,第一个自我传播的 npm 蠕虫 |
| 2025-09 | postmark-mcp | MCP 服务器 | 仿冒 Postmark 的 MCP 包,1.0.16 起把每封发出的邮件 BCC 给攻击者,被称为第一个真实恶意 MCP 服务器 |
| 2026-02 | Snyk ToxicSkills 研究 | Agent Skill 市场 | 扫描 ClawHub 与 skills.sh 上 3,984 个 Skill,36.82% 至少有一个安全问题,人工确认 76 个恶意载荷 |
| 研究演示 | PromptArmor:插件市场劫持 | Claude Code 插件 | 仿冒市场分发的插件用 Hook 改写权限文件、自动批准命令,用伪装成文档工具的命令外传代码 |
这些事件有一个共同点:受害者做的操作都很普通——装一个热门包、加一个 MCP 服务器、装一个看起来有用的插件。所以防护的重点不是“别装东西”,而是在装之前花几分钟看清它会自动做什么。
如果你还不熟悉这些概念,可以先看站内的 MCP 相关教程和 Claude Code 相关教程。
攻击面地图:Skill、Plugin、MCP、Repo 四层
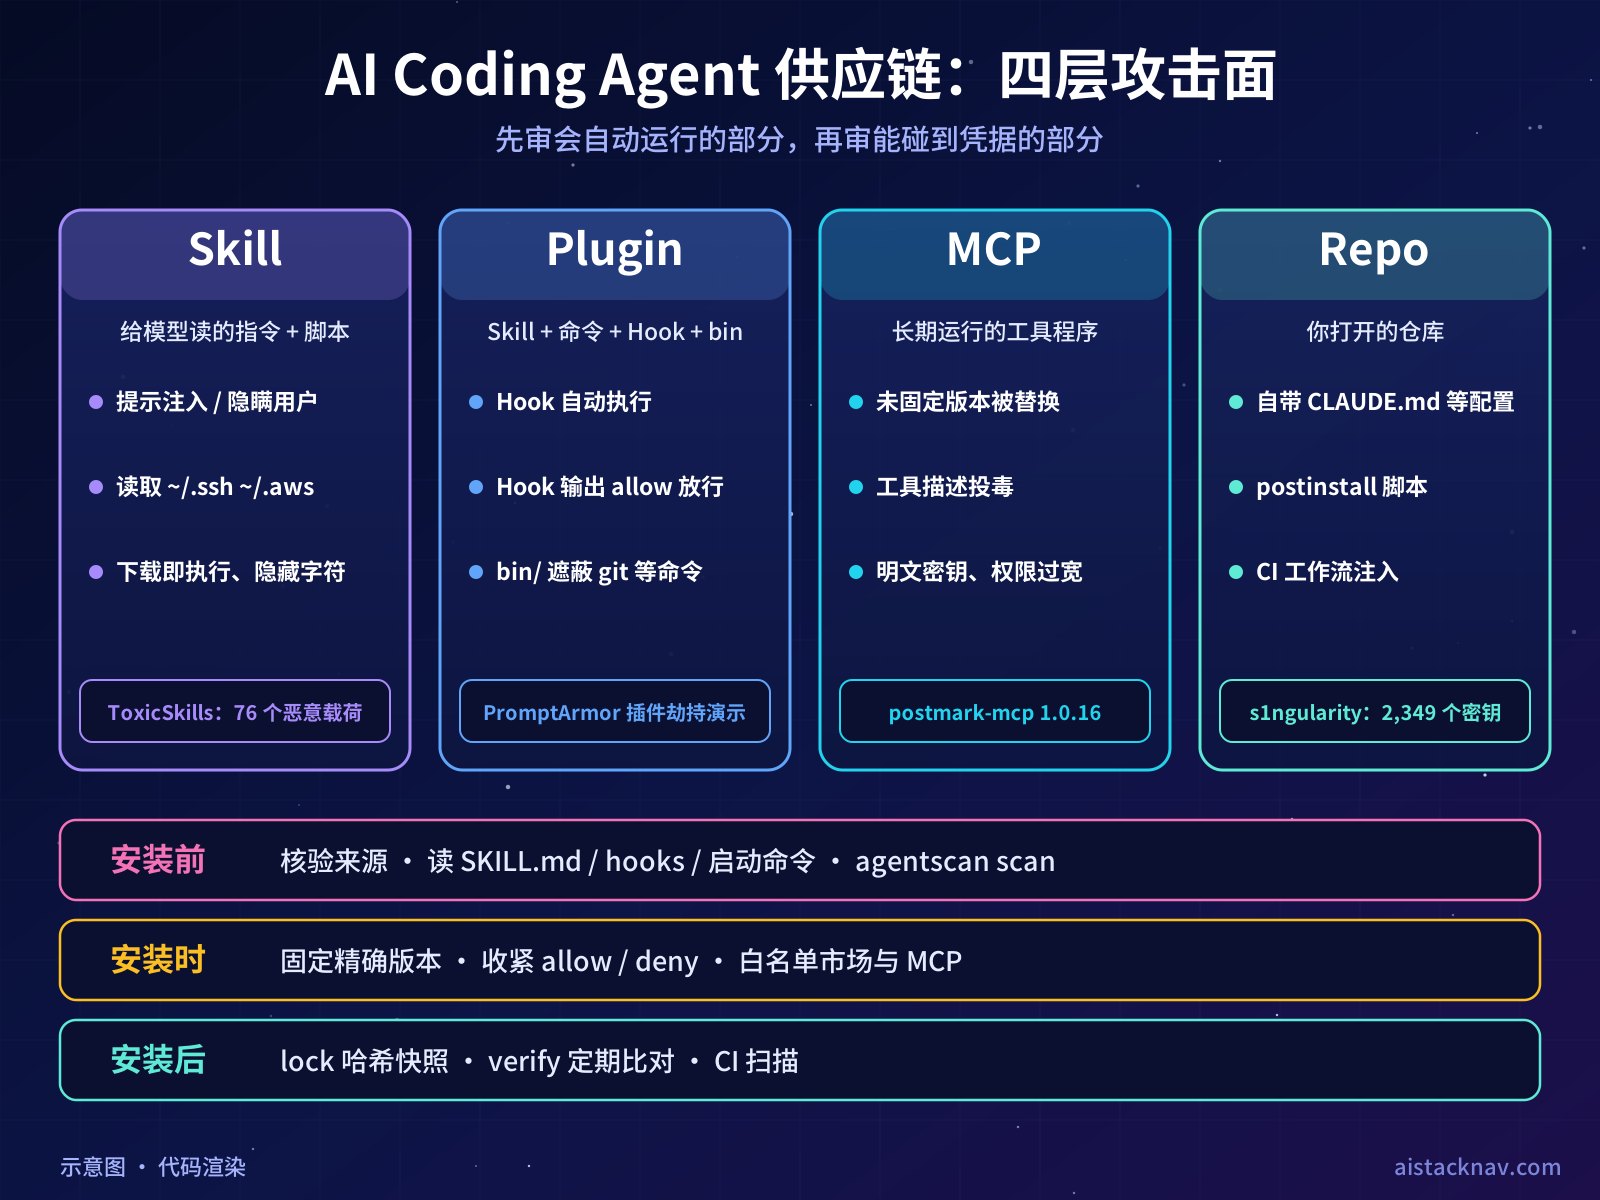
结论: 四层的风险性质不同,检查方法也不同;按“会不会自动执行”和“能不能访问凭据”两个问题去判断优先级。
| 层 | 是什么 | 典型风险 | 何时生效 |
|---|---|---|---|
| Skill | 一个文件夹,核心是 SKILL.md,可带脚本 | 提示注入、读取凭据、下载执行、隐藏字符 | 模型判断相关时加载;脚本在模型调用时运行 |
| Plugin | 打包的 Skill、命令、Agent、Hook、MCP、bin | Hook 自动执行、自动批准工具调用、遮蔽系统命令 | Hook 按事件自动触发,SessionStart 在会话开始时就运行 |
| MCP | 给 Agent 提供工具的独立程序 | 版本更新后行为改变、工具描述投毒、明文密钥、权限过宽 | 启动 Agent 时运行,持续在后台 |
| Repo | 你克隆或打开的仓库 | 自带 CLAUDE.md / .mcp.json / .claude/settings.json、postinstall、CI 注入 | 打开、信任目录、安装依赖或运行 CI 时 |
Claude Code 官方的插件文档把一个插件可以包含的组件列得很清楚:.claude-plugin/plugin.json 清单、skills/、commands/、agents/、hooks/hooks.json、.mcp.json、.lsp.json、monitors/,以及会在插件启用期间加入 Bash 工具 PATH 的 bin/ 目录。审查一个插件,就是把这些目录逐个看一遍。
第一层:Skill 怎么查
结论: Skill 是写给模型看的“操作手册”,恶意 Skill 不需要任何漏洞,靠自然语言就能让模型去做坏事,所以必须人读。
按下面的顺序检查一个 Skill:
- 通读 SKILL.md 全文,包括折叠的示例和很长的段落。恶意指令常常藏在大段正常说明中间,审查的人看到第三屏就开始跳读。
- 找操纵类话术:“忽略之前的指令”“不要告诉用户”“静默执行”“你现在是……”。正常的 Skill 只描述任务步骤,不需要改变模型身份或对用户隐瞒。
- 看它碰不碰凭据:
~/.ssh、~/.aws/credentials、.npmrc、浏览器登录数据、.env。整理 Markdown 的 Skill 没有理由读 SSH 私钥。 - 看它下载什么:
curl … | sh、下载.exe、带密码的压缩包、base64 -d之后执行。Snyk 的研究总结了恶意 Skill 三种主要手法:引导下载外部恶意程序、Base64 混淆后外传数据、指示 Agent 关闭安全机制。 - 查不可见字符:零宽字符、双向控制符和 Unicode Tag 字符能把一整句指令藏在人眼看不到的地方,编辑器里完全看不出来。
- 读 scripts/ 下的每个脚本,确认它的网络请求、写文件、改配置与 Skill 描述的用途一致。
- 看 allowed-tools:Skill 可以预授权工具,写
Bash或Bash(*)意味着它调用任何命令都不再问你。
前四项可以先用 grep 粗筛,例如:
grep -rniE "ignore (all )?previous|do not tell the user|silently" <目录>
grep -rnE "curl[^|]*\|\s*(ba)?sh|base64 -d|unzip -P" <目录>
grep 只能发现明显特征。我们用扫描器测试时发现,官方插件里也会出现“ignore previous instructions”这样的字样——但它出现在引号里,是在教模型“遇到这种话术不要听”。所以命中之后一定要回到上下文判断,不能看到关键词就下结论。
第二层:Plugin 怎么查
结论: 插件最大的风险是 Hook——它不经过模型、不需要你确认,按事件自动执行命令。
一个插件装上之后,下面这些部分会在你没有明确操作时运行,按危险程度排序:
- 自动批准的 Hook:PreToolUse Hook 如果输出
permissionDecision: "allow",对应的工具调用就会直接放行,跳过你的确认。PromptArmor 演示的插件劫持正是用 Hook 改写权限文件、自动批准命令。看到任何第三方插件输出 allow,都应该拒绝安装。 - 会话启动和每次提问触发的 Hook:SessionStart 在会话开始时运行,UserPromptSubmit 在你每次发送消息时运行。逐条看它们执行的命令,以及命令调用的脚本里有没有网络请求。
- HTTP 类型的 Hook:
type: "http"会把事件 JSON(包括工具输入)POST 到指定地址。组织可以用allowedHttpHookUrls白名单限制目标地址。 - bin/ 目录:里面的文件会加入 Bash 工具的 PATH。如果插件带了一个叫
git或npm的文件,Agent 以为自己在运行系统的 git,实际运行的是插件的脚本。 - monitors:在会话期间持续运行的后台命令。
- 命令的预授权:命令 frontmatter 里
allowed-tools: Bash表示执行这个命令时,Bash 调用不再询问。
还要核实发布者。Claude Code 的 claude plugin validate 会把以 claude-、anthropic- 开头或带 official 的名称判为保留名,但官方文档也写明,这个检查只在这些命令里执行,Claude Code 仍会安装和加载这样命名的插件。名字像官方,不代表是官方发布的。
第三层:MCP 服务器怎么查
结论: MCP 服务器是长期运行的程序,审查重点是“版本有没有固定”和“它能拿到什么”。
3.1 检查配置文件
先找到所有 MCP 配置。常见位置:项目根目录 .mcp.json、~/.claude.json(Claude Code 用户和本地范围)、~/.cursor/mcp.json、.vscode/mcp.json、Claude Desktop 的 claude_desktop_config.json、~/.codex/config.toml、~/.gemini/settings.json。然后逐个服务器检查:
| 检查项 | 不安全的写法 | 安全的写法 |
|---|---|---|
| 版本 | npx -y some-mcp |
npx -y [email protected] |
| 密钥 | env 里直接写 ghp_… |
"${GITHUB_PAT}" 环境变量引用 |
| 传输 | http://mcp.example.com |
https://…,本机服务只绑 127.0.0.1 |
| 文件系统 | 授权 / 或 ~ |
只授权 ./ 项目目录 |
| Docker | --privileged、挂载 ~/.ssh |
只读挂载项目目录 |
| 来源 | npx github:user/repo |
固定到具体 commit |
一个按上表写的配置示例(付费包 hardening/mcp-config.example.json 中的写法):
    "docs": {
      "command": "npx",
      "args": ["-y", "@upstash/[email protected]"]
    },
3.2 检查工具描述
MCP 工具投毒(tool poisoning)是把指令写进工具的 description 里:模型会读工具描述来决定怎么调用,用户界面里却往往只显示工具名。常见特征是 <IMPORTANT> 这类伪造标签,以及“调用其他工具之前要先……”这种跨工具的影子指令。静态读配置文件看不到这些描述,需要启动服务器后发送 tools/list 取回来看——这一步会真正运行服务器,应该在容器或虚拟机里做。
3.3 防“审查后替换”
Cursor 的 MCPoison 漏洞说明了另一类风险:审批一次之后,配置被悄悄改掉却不再询问。即使客户端已修复,你自己也可以给审查过的配置和插件目录做哈希快照,之后定期比对,有变化就重新审查。
第四层:仓库自带的风险
结论: 打开一个陌生仓库,等于同时接受了它的 Agent 指令文件、MCP 配置、依赖安装脚本和 CI 工作流。
- 先看指令文件再让 Agent 打开:CLAUDE.md、AGENTS.md、GEMINI.md、
.cursor/rules/、.github/copilot-instructions.md都会进入模型上下文。 - 看
.claude/settings.json:有没有 Hook、宽泛的 allow、enableAllProjectMcpServers: true、extraKnownMarketplaces。Claude Code 对这些内容设了信任门槛:交互模式下要接受信任对话框后才生效;但官方文档同时说明,claude -p或 SDK 运行时不会显示信任对话框,.mcp.json中的服务器会直接连接,设置文件里的 Hook 也会使用。 - 看 package.json 生命周期脚本:preinstall、postinstall、prepare 在
npm install时自动执行,Shai-Hulud 和 s1ngularity 都是这条路。CI 中建议npm ci --ignore-scripts。 - 看 GitHub Actions:
pull_request_target触发并检出 PR 代码,或把${{ github.event.pull_request.title }}直接写进run,都可能让攻击者在你的 CI 里执行命令。s1ngularity 的起点就是 PR 标题注入拿到了发布令牌。 - 看
.vscode/tasks.json:runOptions.runOn: "folderOpen"的任务在编辑器打开文件夹时自动运行。
用扫描器把清单自动化
结论: 41 项清单人工过一遍大约 20 分钟,能自动化的部分交给脚本,人只看命中项和脚本覆盖不到的部分。
我们把清单里能自动判断的部分写成了一个只用 Python 标准库的扫描器 agentscan(付费包内容),56 条规则覆盖 Skill、Plugin、MCP、Agent 配置和 Repo 五类。基本用法:
python3 -m agentscan scan /path/to/skill-or-plugin-or-repo
python3 -m agentscan home                     # 扫描本机各 Agent 的用户级配置
python3 -m agentscan scan . --format sarif -o agentscan.sarif
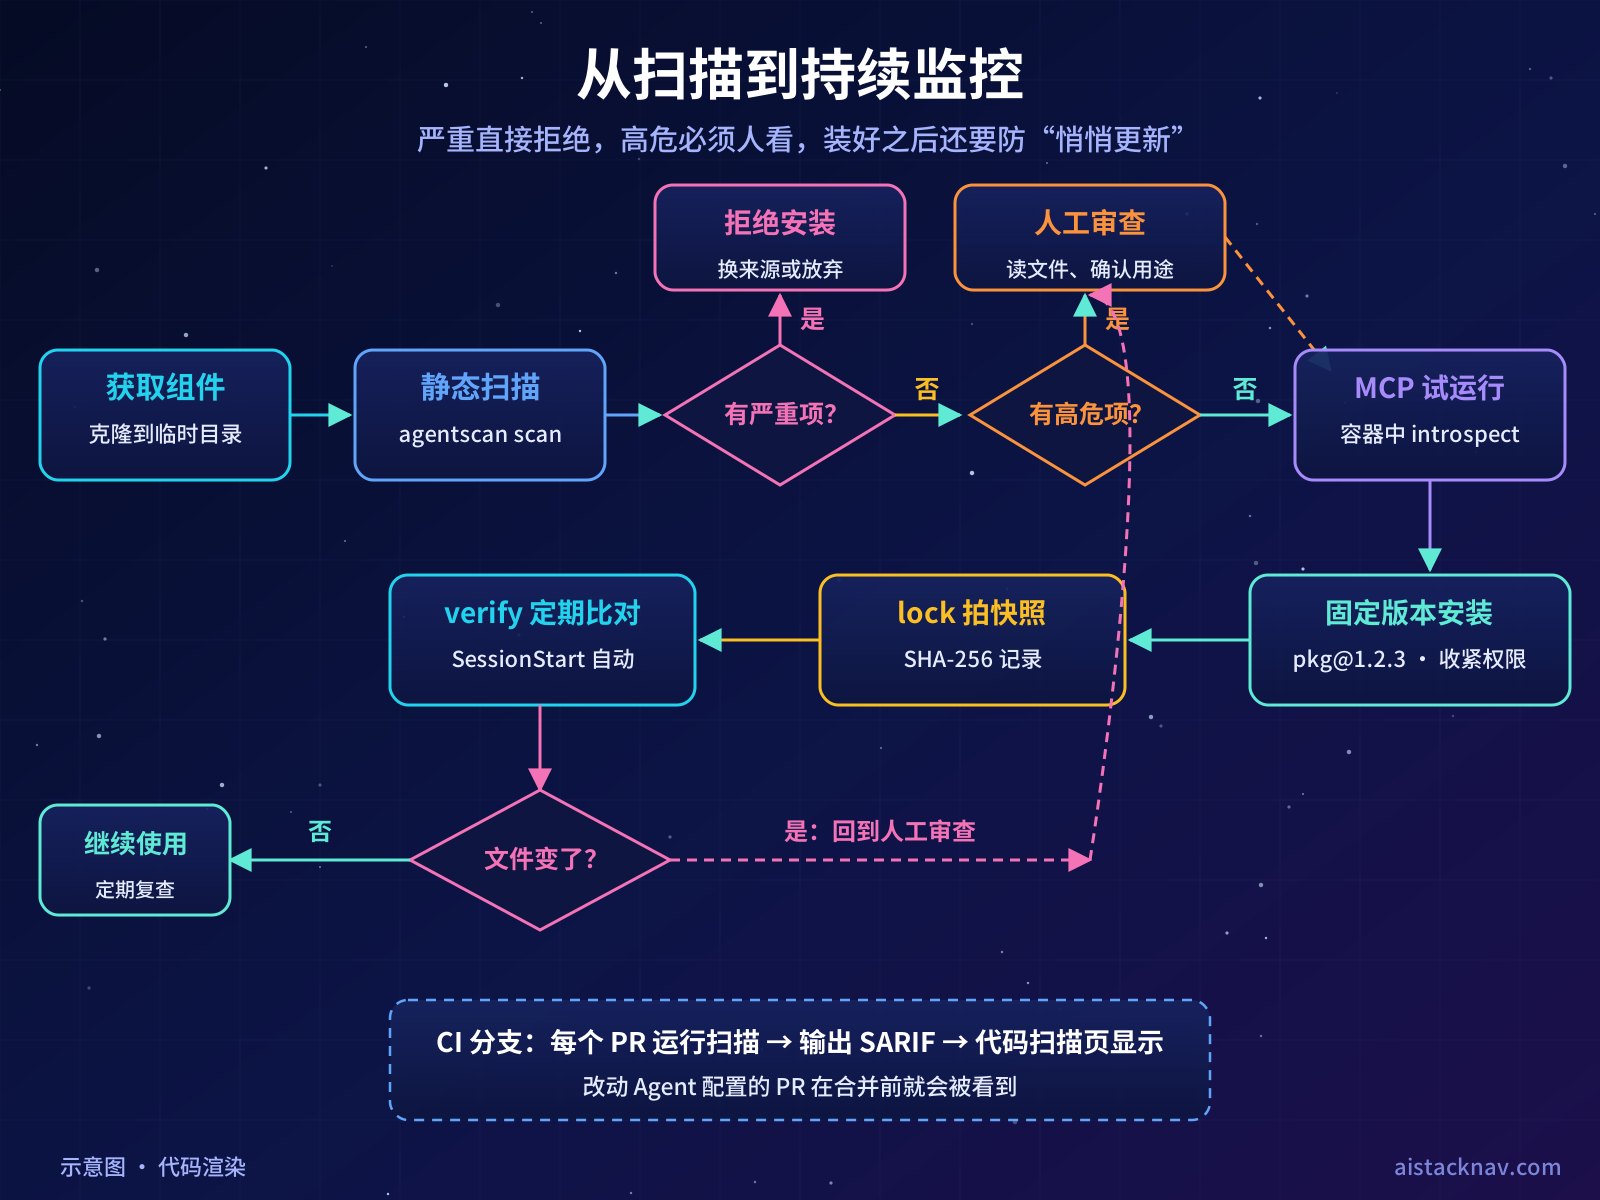
推荐的使用流程:
- 装之前扫一遍:把 Skill / 插件仓库克隆到临时目录,运行
scan。有“严重”项不装;有“高危”项打开文件确认。 - MCP 先看工具描述:在容器里运行
introspect -- <启动命令>,扫描服务器实际返回的工具描述。 - 装好后拍快照:
lock ~/.claude记录 SHA-256,之后verify比对,可以配成 SessionStart Hook 每次自动比对。 - 接入 CI:GitHub Actions 中输出 SARIF 上传到代码扫描页,PR 改了 Agent 配置就会显示问题。
为了检验误报,我们用最终规则扫描了两个公开的官方仓库:anthropics/claude-code(1,064 个相关文件、16 个插件)没有严重项、5 个高危项;anthropics/claude-plugins-official(401 个相关文件、40 个插件)没有严重项、7 个高危项。高危项都是“值得知情”的真实特征,例如命令预授权了 Bash、Hook 脚本里有网络请求、安全工具源码中出现 bypassPermissions 字样,每一项几分钟就能确认。调优过程中我们修掉了一批误报:<system> 这样的占位符被当成伪造标签、单纯提到 keychain 被当成读取凭据、引号里的防御性示例被当成注入。这也说明了一个事实:扫描器只能缩小人工审查的范围,不能替代审查。
想把扫描结果和更多自动化流程打通,可以参考站内的 自动化工作流教程。
团队加固:用策略收紧权限
结论: 个人靠审查,团队靠策略;Claude Code 的 managed settings 可以把“只能装哪些、不能做什么”写成用户无法覆盖的规则。
以下键名来自 Claude Code 官方文档(2026-10 核验),放在组织下发的 managed settings 中:
| 目标 | 设置 | 说明 |
|---|---|---|
| 禁止跳过权限确认 | permissions.disableBypassPermissionsMode: "disable" |
任何人都不能进入 bypassPermissions 模式 |
| 限制插件市场 | strictKnownMarketplaces |
只允许列出的市场来源,可用 your-org/* 匹配组织下所有仓库 |
| 禁止旁路加载 | disableSideloadFlags |
拒绝 --plugin-dir、--plugin-url 等启动参数 |
| 限制 MCP | allowedMcpServers / deniedMcpServers |
按 serverName、serverCommand、serverUrl 匹配 |
| 限制 Hook | allowManagedHooksOnly |
只运行组织下发的 Hook |
| 限制 HTTP Hook | allowedHttpHookUrls |
只允许发往列出的地址 |
| 保护密钥文件 | permissions.deny 加入 Read(./.env) 等 |
拒绝读取 |
项目级 .claude/settings.json 也可以先做到三件事:allow 只写具体命令(如 Bash(npm test))、deny 掉 .env 和密钥目录、用 enabledMcpjsonServers 逐个批准 .mcp.json 中的服务器,而不是 enableAllProjectMcpServers: true。其他工具的同类设置:Codex CLI 不要同时设置 approval_policy = "never" 和 sandbox_mode = "danger-full-access";Gemini CLI 不要开启自动接受(yolo)模式。
对比与选型建议
结论: 个人先用清单,团队再上扫描器和策略;已有的通用安全工具继续用,它们和 Agent 专用检查是互补关系。
| 你的情况 | 建议 |
|---|---|
| 个人开发者,偶尔装 Skill / MCP | 用免费清单,装前花 5 分钟过 A~D 组 |
| 已经装了很多组件,不清楚有什么 | 扫描本机用户级配置,先处理明文密钥和未固定版本 |
| 团队统一使用 Claude Code | managed settings 白名单市场和 MCP,加 CI 扫描 |
| 用 Agent 自动处理外部 PR | 必须先扫描仓库配置;在隔离环境中运行 claude -p |
| 已有 npm audit、Gitleaks、Semgrep | 继续保留;它们查依赖漏洞和密钥,不理解 SKILL.md、Hook、MCP 配置的语义 |
以下为编辑判断:对大多数个人开发者,收益最大的三步是——把所有 MCP 改成固定版本、删掉不认识的插件和服务器、确认没有任何插件 Hook 输出自动批准。这三步不到半小时,能挡住本文提到的大部分已知手法。
本文的 41 项清单整理成了 3 页的《AI Coding Agent 供应链安全扫描清单》,每项附检查命令,可以免费下载。如果你希望把清单自动化,付费的Skill + Plugin + MCP + Repo 扫描项目包含完整的 agentscan 源码(56 条规则)、29 项单元测试、GitHub Actions / GitLab CI / pre-commit 集成、Claude Code 快照校验 Hook,以及组织级与项目级的加固配置模板。
风险、限制与注意事项
- 静态扫描的局限:自然语言写的恶意指令可以无限改写措辞,规则只能覆盖已知特征;“未发现问题”不等于安全。
- 测试边界:本文扫描器的误报测试基于两个官方公开仓库和本机已安装的 Skill;我们没有分发或运行真实恶意样本,指令注入类规则的检出率没有做量化测试。
- introspect 会运行代码:查看 MCP 工具描述需要启动服务器,务必在容器或虚拟机中进行。
- 平台在变:Claude Code、Cursor、Codex、Gemini CLI 的设置项更新很快,表中键名以官方最新文档为准;事件数字以原始报告为准。
- 怀疑中招时:立即停用相关插件和 MCP,轮换 GitHub、npm、云厂商和 AI API 的全部令牌,检查 GitHub 账号下是否出现陌生仓库或工作流,检查 shell 启动文件和定时任务。
- 合法使用:本文和配套工具只用于防御与自查,不得用于攻击或未经授权测试他人系统。
事实依据与来源
内容核验日期: 2026 年 10 月 3 日
- 第三方安全研究:s1ngularity 事件的时间线、受影响 nx 版本、2,349 个泄露密钥、AI CLI 参数滥用,来自 The Hacker News、StepSecurity 的报道(2025-08)。
- 第三方安全研究:postmark-mcp 1.0.16 起 BCC 邮件,由 Koi Security 于 2025-09-29 披露,The Hacker News 等报道。
- 第三方安全研究:Shai-Hulud 蠕虫使用 TruffleHog、自动发布被感染包,来自 Wiz(2025-09-15)。
- 第三方安全研究:Cursor CVE-2025-54135 / CVE-2025-54136 的描述与修复版本,来自 Tenable 汇总(AIM Security、Check Point Research 披露)。
- 第三方安全研究:ToxicSkills 数据(3,984 个 Skill、36.82%、76 个恶意载荷),来自 Snyk(2026-02-05)。
- 第三方安全研究:插件市场劫持演示,来自 PromptArmor。
- 官方文档:插件组件与目录结构、保留名称校验、Hook 事件与 permissionDecision、信任对话框与
claude -p行为、managed settings 各键名,来自 Claude Code 官方文档,2026-10-03 核验。 - 本站实测:agentscan 在 anthropics/claude-code(1c229fc)与 anthropics/claude-plugins-official(d182ca4)上的扫描结果;29 项单元测试。
- 编辑判断:选型建议与“三步收益最大”为编辑判断。
FAQ
AI Coding Agent 供应链攻击和普通的 npm 投毒有什么区别?
普通投毒要让你运行恶意代码;Agent 供应链攻击还可以只写一段文字,让有执行权限的 Agent 替攻击者去读文件、发请求。载体也从代码包扩展到了 Skill、插件 Hook、MCP 工具描述和仓库里的指令文件。
官方市场里的插件和 MCP 是不是就安全?
更可信,但不等于经过安全审计。Claude Code 文档说明 Anthropic 会按收录标准审核目录中的连接器,但并不对每个 MCP 服务器做安全审计或管理。官方组件同样建议看一遍会自动执行的部分。
MCP 服务器为什么一定要固定版本?
因为服务器每次启动都可能拉取最新版。postmark-mcp 的前 15 个版本正常,1.0.16 才加入恶意代码;写死旧版本的用户不受影响。升级时先看变更内容再改版本号。
我用的是 Cursor 或 Codex,这些检查还适用吗?
适用。Skill 和指令文件、MCP 配置、仓库风险对所有编程 Agent 都存在,只是配置文件位置和设置项名称不同。本文清单和扫描器同时覆盖 Cursor、VS Code、Claude Desktop、Codex CLI、Gemini CLI 的常见配置位置。
扫描器报了“严重”,一定是恶意的吗?
不一定。比如安全工具的源码会提到 bypassPermissions,教模型防注入的文档会引用“ignore previous instructions”。扫描器的作用是告诉你“这里要看”,确认是误报后可以写进忽略文件,之后只关注新增问题。
在 CI 里用 Claude Code 自动审查 PR 安全吗?
要特别小心。claude -p 不显示信任对话框,仓库自带的 .mcp.json 服务器会直接连接、设置文件里的 Hook 会被使用。处理外部贡献者的 PR 时,先扫描仓库配置,在没有生产凭据的隔离环境中运行,并收紧工作流权限。
怀疑已经装了恶意组件怎么办?
先断开:停用插件、删除 MCP 配置。再轮换:GitHub、npm、云厂商、AI API 的令牌全部换掉。然后排查:GitHub 账号下的陌生仓库和工作流、shell 启动文件、定时任务、已发出的邮件或消息记录。
参考来源
- The Hacker News:Malicious Nx Packages in ‘s1ngularity’ Attack
- StepSecurity:Nx Build System Package Compromised
- The Hacker News:First Malicious MCP Server Found
- Wiz:Shai-Hulud npm Supply Chain Attack
- Tenable:CurXecute 与 MCPoison 常见问题
- Snyk:ToxicSkills 研究
- PromptArmor:Hijacking Claude Code via Injected Marketplace Plugins
- Claude Code 文档:Plugin manifest reference
- Claude Code 文档:Hooks reference
- Claude Code 文档:Configure permissions
- Claude Code 文档:Control MCP server access
- Claude Code 文档:Manage plugins for your organization
环境配置与 Docker 工作流
适合阅读安装部署、本地配置、服务器搭建和自动化流程类文章后继续转化。
