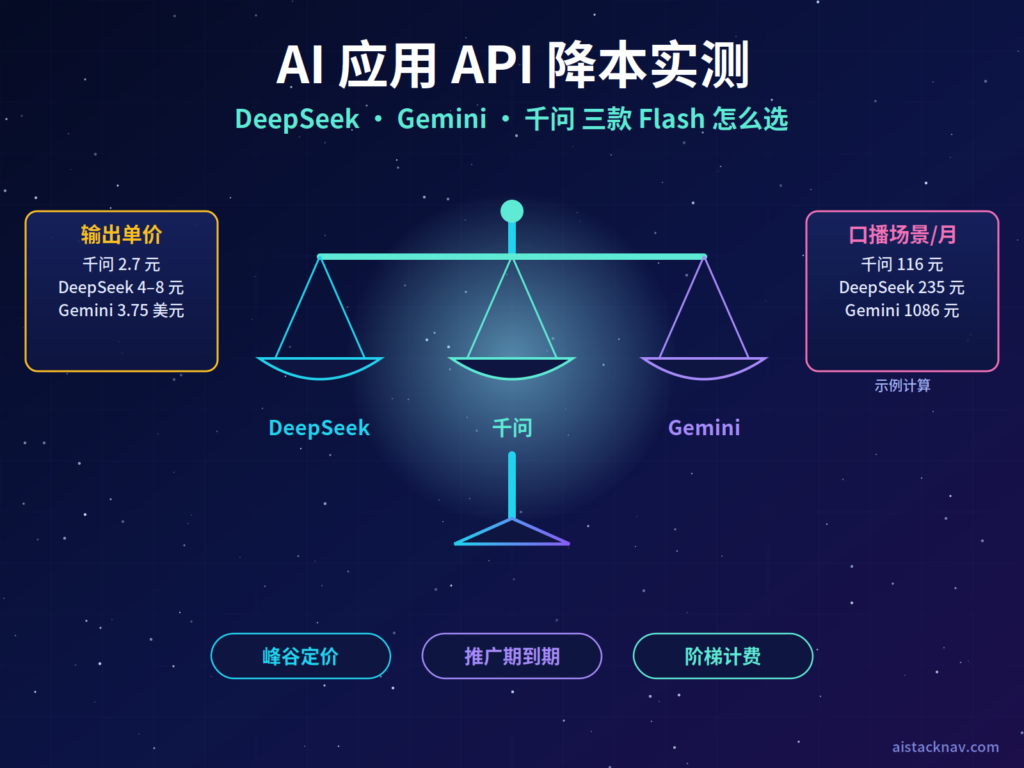
摘要: 本文比较 DeepSeek V4.1 Flash、Gemini 3.8 Flash 和千问 Flash 系列三款“快而便宜”的大模型 API,回答独立开发者最关心的问题:做 AI 小工具,调用哪家最省钱。最重要的结论是:按各家官方价格计算,千问 Flash 在我们测算的三个典型场景里都最便宜,DeepSeek V4.1 Flash 约为千问 qwen3.8-flash 的两倍、但错峰调用能再省一半,Gemini 3.8 Flash 按人民币折算后贵出一个数量级,而且 2027 年起价格翻倍。本文适合正在做或准备做 AI 应用的个人开发者和小团队。需要说明的是,本文的“实测”是用官方单价加可运行的成本测算工具算出来的,并没有用真实 API Key 比较三家的回答质量和延迟;文末附带的测试脚本可以让你用自己的提示词补上这一步。读完本文,你能看懂三家的计费规则、算出自己业务的月度成本,并知道在什么场景该选哪一家。
配套项目源码:下载 LLM API 成本计算与对比工具(ZIP)。解压后阅读 README.md,并在本地填写环境变量。
核心结论
只看价格,千问 Flash 最便宜,DeepSeek V4.1 Flash 次之,Gemini 3.8 Flash 最贵;但选型不能只看单价,还要看场景长度、调用时段和你的用户在哪里。
- 千问 Flash 单价最低:阿里云百炼官方价格页显示,qwen3.8-flash 在北京地域输入 0.8 元、输出 2.7 元每百万 token;上一代 qwen3.7-flash 在单次输入不超过 32K 时只要输入 0.2 元、输出 0.8 元,是三家里的价格地板。
- DeepSeek 有峰谷价,错峰就是降本:DeepSeek 官方价格页显示,V4.1 Flash 空闲时段输入 1 元、输出 4 元每百万 token,高峰时段翻倍;高峰为北京时间工作日 9:00–12:00 和 14:00–18:00。批量任务挪到晚上和周末,成本直接减半。
- Gemini 3.8 Flash 贵且有涨价时钟:Google Cloud 官方价格页显示,Gemini 3.8 Flash 推广价为每百万 token 输入 0.75 美元、输出 3.75 美元,截至 2026 年 12 月 31 日;2027 年 1 月 1 日起标准价为 1.5 美元和 7.5 美元。
- 输出 token 才是大头:三家的输出单价都是输入单价的 3 到 5 倍。控制回答长度、关掉不必要的思考模式,比换模型更容易省钱。
- 价格不等于性价比:本文没有比较回答质量。建议用附带的 bench.py 拿你的真实提示词各跑一遍,再结合成本做决定。
背景与主要变化
九月是 Flash 级模型集中更新的一个月,三家都把“便宜的快模型”推到了新一代。对开发者来说,这意味着同样的预算能做更多调用,但也意味着旧的成本估算需要重算。
DeepSeek 方面,官方更新日志显示 V4.1 Flash 是其新架构家族中最小的模型,原生支持图像理解;API 模型名改为 deepseek-flash,旧的 deepseek-v4-flash 等名称暂时路由到新模型。DeepSeek 官网公告还说明,自 9 月 14 日起所有 deepseek-v4-pro 请求都路由到 V4.1 Flash 并按 Flash 价格计费,直到 V4.1 Pro 上线。多家第三方媒体报道其发布日期为 2026 年 9 月 10 日。
Google 方面,第三方报道一致称 Gemini 3.8 Flash 于 9 月 2 日发布,而且与 3.7 Flash、3.6 Flash 执行完全相同的推广价(第三方报道,价格本身已在 Google Cloud 官方页面核验)。阿里方面,百炼价格页已上架 qwen3.8-flash,并保留了 qwen3.7-flash、qwen3.5-flash、qwen-flash 等多代 Flash 模型可选。
下表是三款主力 Flash 模型的官方计费要点(核验日期 2026 年 9 月 27 日,单位:每百万 token):
| 项目 | DeepSeek V4.1 Flash | Gemini 3.8 Flash | 千问 qwen3.8-flash(北京) |
|---|---|---|---|
| API 模型名 | deepseek-flash | gemini-3.8-flash(以控制台为准) | qwen3.8-flash |
| 输入(未命中缓存) | 空闲 1 元 / 高峰 2 元 | 0.75 美元(2027 年起 1.5 美元) | 0.8 元 |
| 输入(命中缓存) | 空闲 0.02 元 / 高峰 0.04 元 | 本文未核验 | 享有折扣(官方示例为标准价 10%) |
| 输出 | 空闲 4 元 / 高峰 8 元 | 3.75 美元(2027 年起 7.5 美元) | 2.7 元 |
| 上下文 | 1M | 约 1M(第三方数据) | 1M |
| 特殊规则 | 峰谷定价,高峰价翻倍 | 推广价到 2026 年底 | 北京地域新用户 100 万 token 免费额度 |
还有一个容易被忽略的“省钱档”:千问 qwen3.7-flash 采用阶梯计费,单次请求输入不超过 32K 时输入 0.2 元、输出 0.8 元,32K 到 256K 之间是 0.6 元和 2.4 元。百炼官方说明,阶梯按单次请求的输入总量决定,整个请求(含输出)都按该档单价结算。
核心功能拆解
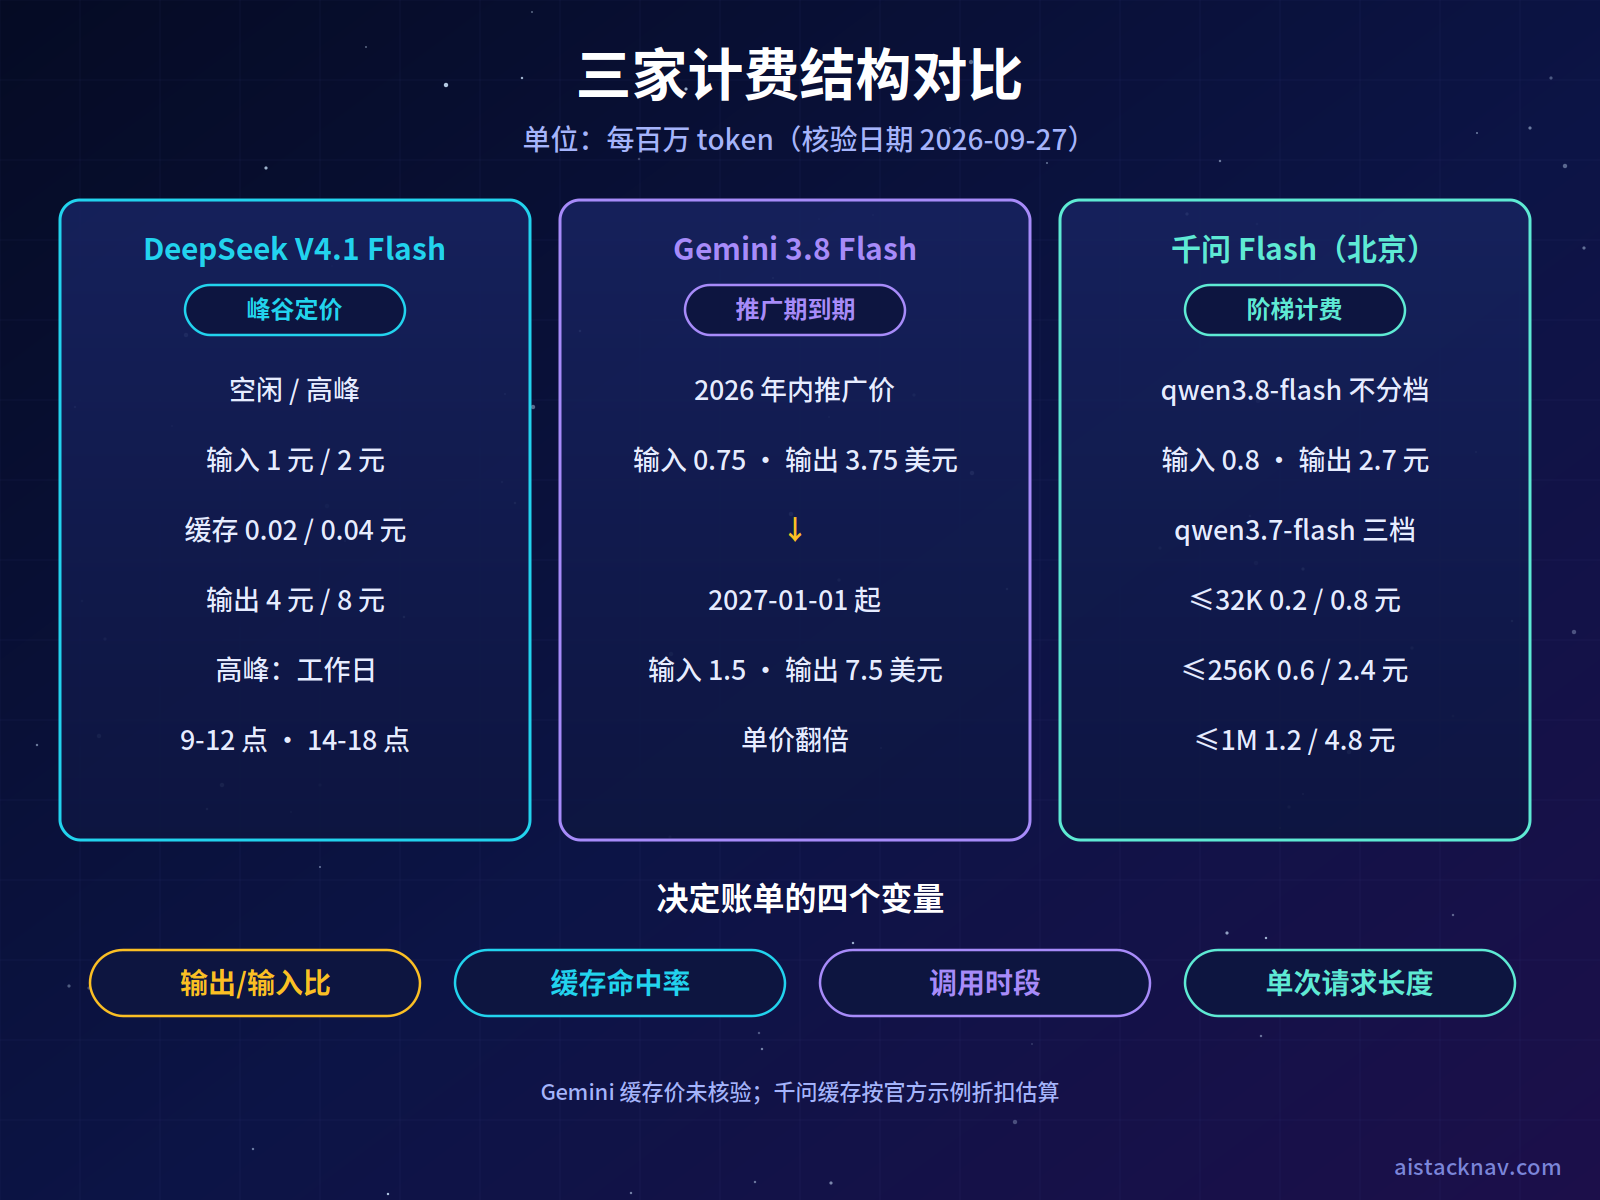
三家的计费结构看起来都是“输入价 + 输出价”,但真正决定账单的是四个变量:输入与输出的比例、缓存命中率、调用时段、单次请求长度。搞懂这四个变量,才能看懂后面的测算结果。
变量一:输出比输入贵得多
DeepSeek 的输出价是输入价的 4 倍,千问 qwen3.8-flash 约 3.4 倍,Gemini 3.8 Flash 是 5 倍。这意味着同样 1000 个 token,放在回答里要比放在提示词里贵得多。写文案、生成长回答这类“输出重”的场景,模型选择对成本影响最大。
需要特别注意思考模式。DeepSeek 官方说明 V4.1 Flash 默认开启思考模式,千问价格表也注明输出单价包含思维链和回答。思考过程产生的 token 按输出计费,简单任务开着思考模式,可能让输出 token 成倍增加。
变量二:缓存命中率
如果你的每次请求都带着一段相同的长系统提示(比如客服知识库、固定角色设定),缓存能让这部分输入几乎免费。DeepSeek 的缓存命中价是 0.02 元,只有未命中价的 2%;千问官方文档说明缓存命中按折扣计费,示例为标准输入价的 10%。Gemini 的缓存价格本文未核验,测算时按全价计算,所以在高缓存场景里 Gemini 的真实成本可能比本文估算低一些。
变量三:调用时段
这是 DeepSeek 独有的变量。官方规定空闲时段价格为高峰时段的一半,北京时间周末和法定节假日全天都是空闲时段。对于数据清洗、批量生成、离线摘要这类不需要实时响应的任务,把它们排到晚上跑是零成本的降本手段。
变量四:单次请求长度
千问的阶梯计费让单次请求长度直接影响单价。qwen3.7-flash 在 32K 以内是最低档,一旦超过就跳到 3 倍价格。处理长文档时,把一篇 6 万 token 的文档切成两段 3 万 token 分别处理,理论上可以回到最低档(切分可能影响摘要质量,需要实测)。
适用人群与使用场景
这篇文章最适合“每个月 API 账单在几十到几千元之间”的个人开发者和小团队。账单太小,换模型省下的钱不值得折腾;账单特别大,应该直接找厂商谈企业价或考虑自部署。
以下是几类典型用户的选型思路(编辑判断,不代表官方结论):
- 做中文 AI 小工具的独立开发者:比如口播文案生成器、标题生成器、公众号改写工具。这类工具输出重、请求短,千问 Flash 的单价优势最明显,站内的 千问相关教程 可以帮你快速接入。
- 做客服、问答机器人的团队:长系统提示加短回答,缓存命中率是关键。DeepSeek 的缓存价极低,千问也有缓存折扣,两者都适合。
- 做编程 Agent、需要强推理的开发者:价格之外更看重能力。第三方报道显示 DeepSeek V4.1 Flash 和 Gemini 3.8 Flash 都主打编程和 Agent 场景,建议用真实任务对比,站内也有 DeepSeek 相关教程。
- 面向海外用户的产品:Gemini 3.8 Flash 在海外生态中接入方便,第三方报道称它已进入 GitHub Copilot 的模型选择器。服务海外用户时,价格劣势可能被生态和合规便利抵消。
- 跑批量离线任务的团队:数据标注、内容批量改写、历史文档摘要,优先考虑 DeepSeek 空闲时段,或千问的 Batch 调用(百炼官方说明部分模型的 Batch 调用按实时价格的 50% 计费)。
安装、配置或使用步骤
三家都提供 OpenAI 兼容接口,这是降本最重要的前提:只要把代码写成 OpenAI 格式,换模型只需要改三个参数(地址、密钥、模型名)。下面用本文附带的 llm-cost-lab 工具演示完整流程,工具只用 Python 标准库,不需要安装任何第三方包。
- 下载并解压 llm-cost-lab。解压后先直接运行成本测算,不需要任何 API Key:
cd llm-cost-lab
python3 cost_calc.py
- 按你的业务修改 scenarios.json。每个场景填写五个数:每日请求数、单次输入 token、单次输出 token、缓存命中率、高峰时段请求占比。例如口播文案生成器的配置:
{
  "口播文案生成": {"requests_per_day": 1000, "input_tokens": 800, "output_tokens": 1200, "cache_hit_rate": 0.0, "peak_share": 0.4}
}
- 核对 prices.json 中的单价。价格文件里的数字来自三家官方价格页,核验日期写在文件开头。价格随时可能调整,每次测算前建议打开官方页面核对一遍;汇率
usd_cny默认按 7.1 计算,请改成你实际结算时的汇率。 - 申请三家的 API Key。DeepSeek 在开放平台申请,千问在阿里云百炼控制台申请,Gemini 在 Google AI Studio 申请。注意千问的最新官方文档中,北京地域的接口地址带有工作空间 ID。
- 填写 .env 配置文件。复制
.env.example为.env,填入你自己的密钥。没有填写密钥的厂商会被自动跳过,所以只想对比其中两家也可以:
# 复制为 .env 后填写;未填写 KEY 的厂商会被跳过
DEEPSEEK_API_KEY=YOUR_API_KEY
DEEPSEEK_BASE_URL=https://api.deepseek.com
DEEPSEEK_MODEL=deepseek-flash
GEMINI_API_KEY=YOUR_API_KEY
GEMINI_BASE_URL=https://generativelanguage.googleapis.com/v1beta/openai
GEMINI_MODEL=gemini-3.8-flash
QWEN_API_KEY=YOUR_API_KEY
QWEN_BASE_URL=https://YOUR_WORKSPACE_ID.cn-beijing.maas.aliyuncs.com/compatible-mode/v1
QWEN_MODEL=qwen3.8-flash
BENCH_TIMEOUT=60
BENCH_MAX_TOKENS=800
- 准备你的真实提示词并运行对比。在
prompts.txt里放入你业务中最常见的几条提示词,用单独一行---分隔,然后运行:
set -a; . ./.env; set +a
python3 bench.py prompts.txt
- 阅读输出结果。脚本会为每家输出成功率、平均延迟、实际消耗的输入输出 token 和折算费用。重点看两件事:同样的提示词,各家实际输出了多少 token(有的模型更啰嗦);回答质量是否满足你的要求(需要人工打开结果判断)。
cost_calc.py 的核心是下面这个单次请求计费函数,它分别处理 DeepSeek 的峰谷价、千问的阶梯价和普通的固定价:
def per_request_cny(model_id: str, inp: int, out: int, hit: float, peak_share: float) -> float:
    """单次请求成本(元)。hit=缓存命中比例,peak_share=高峰时段请求占比(仅 DeepSeek 使用)。"""
    m = PRICES["models"][model_id]
    rate = PRICES["usd_cny"] if m["currency"] == "USD" else 1.0
    fresh, cached = inp * (1 - hit), inp * hit

    def cost(p_in, p_hit, p_out):
        return (fresh * p_in + cached * p_hit + out * p_out) / 1e6 * rate

    if "offpeak" in m:  # DeepSeek 峰谷定价
        o, p = m["offpeak"], m["peak"]
        return (1 - peak_share) * cost(o["input"], o["cache_hit"], o["output"]) + \
            peak_share * cost(p["input"], p["cache_hit"], p["output"])
    if "tiers" in m:  # 千问阶梯:按单次请求输入总量选档,整单同价
        t = next(t for t in m["tiers"] if inp <= t["max_input"])
        return cost(t["input"], t["input"] * m["cache_hit_ratio"], t["output"])
    f = m["flat"]
    if f.get("cache_hit") is not None:
        p_hit = f["cache_hit"]
    elif "cache_hit_ratio" in f:
        p_hit = f["input"] * f["cache_hit_ratio"]
    else:
        p_hit = f["input"]  # 未核实缓存价时按全价计,偏保守
    return cost(f["input"], p_hit, f["output"])
bench.py 对限流(HTTP 429)和服务端错误会自动重试两次,间隔按 1 秒、2 秒递增;其他错误(如密钥错误导致的 401)不会重试,避免无意义地消耗额度。
实际工作流示例
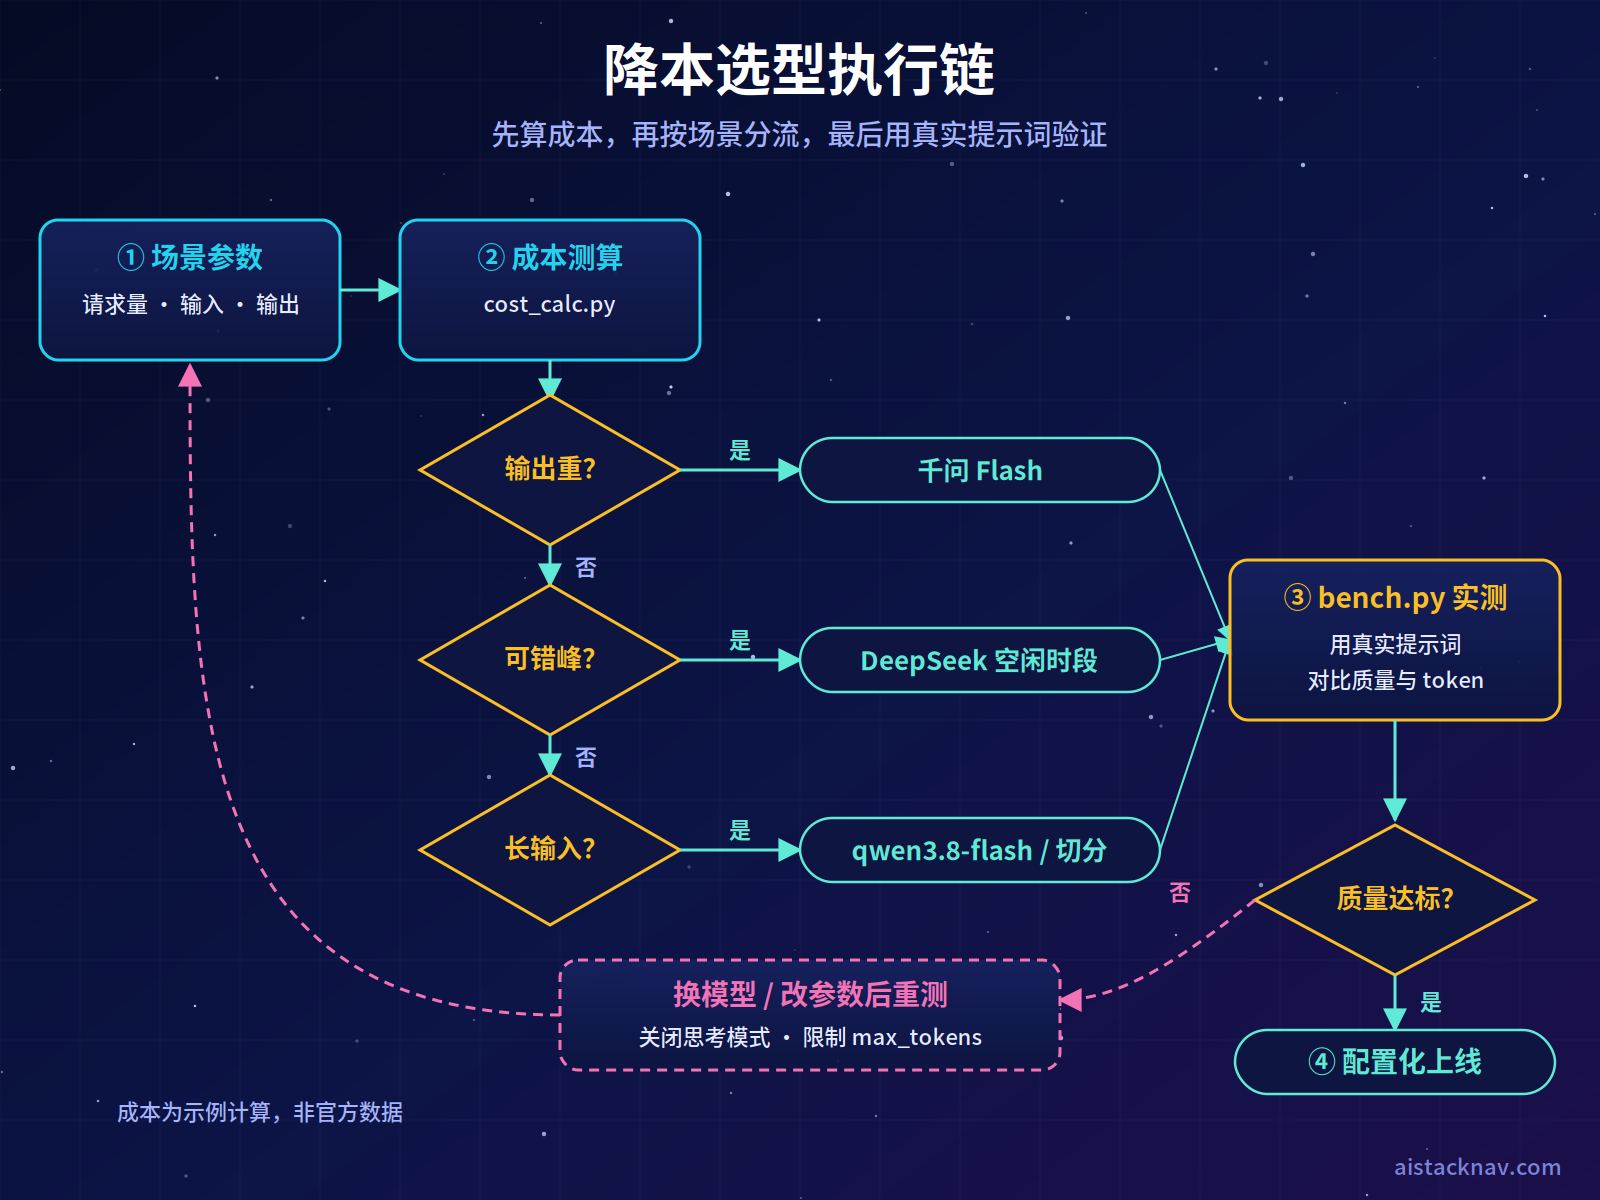
我们用三个典型场景跑了一遍 cost_calc.py,下面是真实运行结果。计算基于官方单价,汇率按 1 美元兑 7.1 元,每月按 30 天计。以下为示例计算,非官方数据。
场景一:口播文案生成器
假设每天 1000 次请求,每次输入 800 token、输出 1200 token,无缓存,40% 的请求发生在高峰时段。月度成本测算结果:qwen3.7-flash 约 33.6 元,qwen3.8-flash 约 116.4 元,DeepSeek V4.1 Flash 约 235.2 元,Gemini 3.8 Flash 推广价约 1086.3 元,2027 年标准价约 2172.6 元。
这是一个典型的“输出重”场景,输出 token 是输入的 1.5 倍,所以输出单价最低的千问优势最大。如果你的工具像这样每天几百到几千次调用,选千问一年能省下的钱相当可观。
场景二:客服问答(长系统提示)
假设每天 5000 次请求,每次输入 4000 token(其中 80% 是可缓存的固定系统提示)、输出 300 token,一半请求在高峰时段。测算结果:qwen3.7-flash 约 69.6 元,qwen3.8-flash 约 255.9 元,DeepSeek V4.1 Flash 约 464.4 元,Gemini 3.8 Flash 推广价约 4393.1 元。
这里 Gemini 的数字偏高,因为我们没有核验它的缓存价,按全价计算了全部输入。即便如此,缓存对另外两家的作用非常明显:DeepSeek 的缓存命中价只有 0.02 元,如果客服系统主要在晚上和周末使用,成本还能进一步降低。
场景三:长文档摘要
假设每天 200 次请求,每次输入 6 万 token、输出 1500 token,无缓存。测算结果:qwen3.7-flash 约 237.6 元,qwen3.8-flash 约 312.3 元,DeepSeek V4.1 Flash 约 514.8 元,Gemini 3.8 Flash 推广价约 2156.6 元。
注意 qwen3.7-flash 在这个场景里的优势明显缩小:6 万 token 超过了 32K 的最低档,整单跳到 0.6 元和 2.4 元的第二档。这正是阶梯计费的特点——短请求极便宜,长请求要么切分、要么换用不分档的 qwen3.8-flash。
离线测试说明
我们用本地假上游(mock_server.py)测试了 bench.py 的完整链路:正常调用 3 条提示词全部成功;让上游第一次返回 429 限流,脚本自动重试后仍然 3 条全部成功;没有配置 Gemini 密钥时,脚本输出“跳过”提示而不是报错;上游不可达时,脚本记录错误类型并继续运行。这些测试验证的是脚本逻辑,不代表各厂商真实服务的表现。
对比与选型建议
选 Flash 模型的正确顺序是:先用成本测算排除明显太贵的,再用真实提示词比较剩下的质量,最后根据用户所在地和合规要求定案。
| 你的情况 | 首选 | 理由 |
|---|---|---|
| 中文小工具,请求短、输出重 | 千问 qwen3.7-flash 或 qwen3.8-flash | 单价最低,短请求可吃到阶梯最低档 |
| 批量离线任务,时间不敏感 | DeepSeek V4.1 Flash(空闲时段) | 空闲时段半价,周末全天空闲 |
| 长系统提示、高缓存命中 | DeepSeek V4.1 Flash 或千问 | 缓存命中价极低 |
| 长文档处理,不想切分 | 千问 qwen3.8-flash | 1M 以内不分档,单价稳定 |
| 海外用户、Google 生态 | Gemini 3.8 Flash | 生态接入便利,但要为 2027 年涨价做预算 |
| 需要看图(图像理解) | DeepSeek V4.1 Flash 或 Gemini | DeepSeek 官方标注 Flash 支持图像理解 |
三条通用建议(实施建议,非官方数据):
- 不要只绑定一家。三家都支持 OpenAI 兼容接口,把模型名和地址放进配置文件,某家涨价、限流或故障时可以快速切换。
- 按场景混用。同一个产品里,简单任务用最便宜的千问 Flash,复杂推理用更强的模型,这种“模型路由”是成熟团队最常用的降本手段。
- 给 Gemini 算两套账。如果选择 Gemini 3.8 Flash,预算要按 2027 年的标准价准备,避免明年账单突然翻倍。
想了解更多模型的 API 接入方法,可以在站内搜索 API 接入教程。
风险、限制与注意事项
降本的前提是服务稳定、结果可用。以下风险在选型和上线时都要考虑。
价格随时可能变。 DeepSeek 官方价格页明确写着保留调整价格的权利;Gemini 3.8 Flash 的推广价有明确截止日期;千问价格表只展示原价,限时优惠需在控制台查看。建议把价格写进配置文件而不是代码,并每月核对一次官方页面。
模型名和路由会变。 DeepSeek 已经把旧模型名路由到新模型,deepseek-v4-pro 目前也按 Flash 计费并由 Flash 提供服务。如果你的代码里写死了旧模型名,行为和费用可能已经悄悄改变。上线前请确认你调用的到底是哪个模型。
思考模式会让 token 暴涨。 DeepSeek V4.1 Flash 默认开启思考模式,思考内容按输出计费。简单任务应按官方文档切换到非思考模式,并用 max_tokens 限制最大输出长度,防止单次请求失控。
限流与并发。 DeepSeek 官方标注 V4.1 Flash 的并发限制为 2500;其他厂商也有各自的限流规则。遇到 429 时应该指数退避重试,而不是立即重复请求。批量任务要控制并发,避免触发限流后整批失败。
重试与幂等。 网络超时不代表请求没有被处理,盲目重试可能导致重复扣费或重复写入。对于会产生副作用的操作(写数据库、发消息),要设计幂等键,保证重复执行结果一致。
密钥安全。 API Key 只放在服务端的环境变量或密钥管理服务里,不要写进前端代码、不要提交到 Git 仓库。给每个项目单独创建密钥,并在控制台设置用量上限和告警,密钥泄露时损失可控。
Prompt Injection 与输出校验。 如果你的工具让用户输入内容再拼进提示词,用户可能通过注入指令改变模型行为。模型返回的结构化数据(如 JSON)要做格式和字段校验,不能直接信任并执行。涉及付款、删除、对外发布、发送邮件、修改权限或操作生产数据库的动作,必须保留人工审批环节。
地区与合规。 三家服务的可用地区、数据存储位置和合规要求不同。千问的免费额度仅适用于北京地域;Gemini API 的可用地区请以 Google 官方列表为准。面向国内用户的产品,还需要关注数据出境和备案等合规要求。
事实依据与来源
本文信息按可信度分级如下:
- 官方已确认:DeepSeek V4.1 Flash 的模型名、峰谷单价、缓存价、高峰时段定义、1M 上下文、384K 最大输出、2500 并发限制,来自 DeepSeek 官方价格页;旧模型名路由规则来自 DeepSeek 官方更新日志和官网公告。Gemini 3.8 Flash 的推广价(0.75/3.75 美元)、截止日期和 2027 年标准价(1.5/7.5 美元),来自 Google Cloud 官方价格页。千问 qwen3.8-flash、qwen3.7-flash 的单价、阶梯规则、Batch 半价、缓存折扣说明和北京地域免费额度,来自阿里云百炼官方价格页。三家的 OpenAI 兼容接口地址来自各自官方文档。
- 第三方报道:DeepSeek V4.1 Flash 发布日期(9 月 10 日)、Gemini 3.8 Flash 发布日期(9 月 2 日)、Gemini 3.8 Flash 上下文长度、进入 GitHub Copilot 等信息,来自第三方媒体和聚合平台,请以官方为准。
- 实测结果:三个场景的月度成本数字由
cost_calc.py在本文写作时实际运行得出;bench.py 的调用、重试和跳过逻辑已在本地假上游上测试。未使用真实 API Key 比较三家的回答质量与真实延迟。 - 示例计算与假设:汇率按 1 美元兑 7.1 元;千问缓存按官方示例折扣 10% 估算;Gemini 缓存价未核验,按全价计算;场景参数为假设值。
- 编辑判断:人群选型思路和选型表为本站编辑判断,不代表官方结论。
内容核验日期为 2026 年 9 月 27 日。
FAQ
三家里哪个 API 最便宜?
按官方单价,千问 Flash 最便宜。在本文测算的三个场景中,qwen3.7-flash 和 qwen3.8-flash 都低于 DeepSeek V4.1 Flash,Gemini 3.8 Flash 按人民币折算后最贵。
DeepSeek 的高峰时段是什么时候?
北京时间周一至周五的 9:00–12:00 和 14:00–18:00,法定节假日除外。其余时间包括周末全天都是空闲时段,价格为高峰时段的一半。
Gemini 3.8 Flash 明年会涨价吗?
会涨。Google Cloud 官方价格页显示推广价截至 2026 年 12 月 31 日,2027 年 1 月 1 日起输入和输出单价都翻倍。
qwen3.7-flash 和 qwen3.8-flash 该选哪个?
请求短就选 qwen3.7-flash,请求长就选 qwen3.8-flash。qwen3.7-flash 在单次输入 32K 以内价格最低,超过后会跳档;qwen3.8-flash 在 1M 以内不分档,单价稳定。两者的能力差异请用真实提示词实测。
换模型需要重写代码吗?
不需要重写。三家都提供 OpenAI 兼容接口,通常只需修改接口地址、API Key 和模型名三个参数,本文附带的 llm-cost-lab 就是这样实现的。
本文的“实测”包括回答质量吗?
不包括。本文的成本数字来自官方单价和可运行的测算工具,没有用真实 API 比较回答质量和延迟。建议用附带的 bench.py 和你自己的提示词完成这一步。
思考模式会影响成本吗?
影响很大。思考过程产生的 token 按输出单价计费,简单任务开着思考模式可能让费用成倍增加。按官方文档关闭思考模式或限制最大输出长度可以有效控制成本。
参考来源
- DeepSeek API 文档:模型与价格
- DeepSeek API 文档:更新日志
- DeepSeek 官网:DeepSeek-V4.1-Flash 发布公告
- Google Cloud:生成式 AI 价格
- Gemini API:OpenAI 兼容说明
- 阿里云百炼:模型调用价格
- 阿里云百炼:OpenAI Chat 接口兼容
- OpenRouter:Gemini 3.8 Flash 模型信息(第三方)
内容核验日期:2026 年 09 月 27 日
会员充值与订阅排查资料
适合阅读会员充值、订阅购买、权益对比和支付问题类文章后继续转化。
