
摘要: Coding Agent 的“Codebase Indexing”通常不等于把整个 Git 仓库永久明文保存到模型厂商,也不等于源码绝不会离开电脑。实际数据流可能包括:上传代码分块生成向量、保存向量和路径/哈希等元数据、在每次提问时发送检索出的代码片段,以及把仓库克隆到云端沙箱执行。本文基于 Cursor、GitHub Copilot、Claude Code 与 OpenAI Codex 的官方说明,解释源码究竟去了哪里、哪些开关会改变训练与保留规则,并给出个人开发者和企业团队可直接执行的审计、隔离与回退方案。结论是:可以使用代码索引,但机密仓库不能仅凭“本地客户端”或“不开训练”就判断安全,必须逐层核验传输、存储、推理、日志和第三方模型链路。
核心结论
源码可能被上传到索引服务、模型推理服务或云端 Agent 执行环境;具体去向取决于产品、功能、账户类型、隐私模式和管理员策略。所谓“索引”只是链路中的一个阶段,不能单独代表完整的数据处理方式。
- Codebase Indexing 不必然等于永久保存明文源码。 有的产品上传代码分块计算 embedding,持久保存的是向量、文件路径、行号或哈希;但生成向量时明文仍会经过远端服务。
- “不用于训练”不等于“零保留”。 服务可能为缓存、滥用监测、会话恢复、错误反馈或云端任务保存内容;训练、保留、人工访问是三组不同问题。
- 本地运行不等于离线运行。 Claude Code 等客户端可在本机执行命令,但与大模型交互时仍需把提示词、模型输出及任务所需上下文通过网络发送给所选提供商。
- 云端 Agent 的数据面更大。 Codex Cloud、Claude Code Cloud 等模式可能把仓库克隆进隔离虚拟机;这与只上传检索片段的 IDE 问答不是同一风险等级。
- 企业选型应看数据流而不是产品口号。 至少确认索引位置、明文生命周期、向量与元数据保留、模型供应商、区域、删除机制、审计能力和内容排除策略。
为什么“源码到底上传到了哪里”很难一句话回答
Coding Agent 为了回答“这个函数在哪里被调用”“修改登录流程会影响哪些模块”,需要先找到相关代码。最简单的方式是把当前文件和打开的标签页直接放进提示词;更复杂的方式是把仓库切成代码块,为每个代码块生成 embedding,再通过语义搜索找出相关片段。Agent 模式还可能读取文件、运行测试、查看 Git 历史和依赖配置。
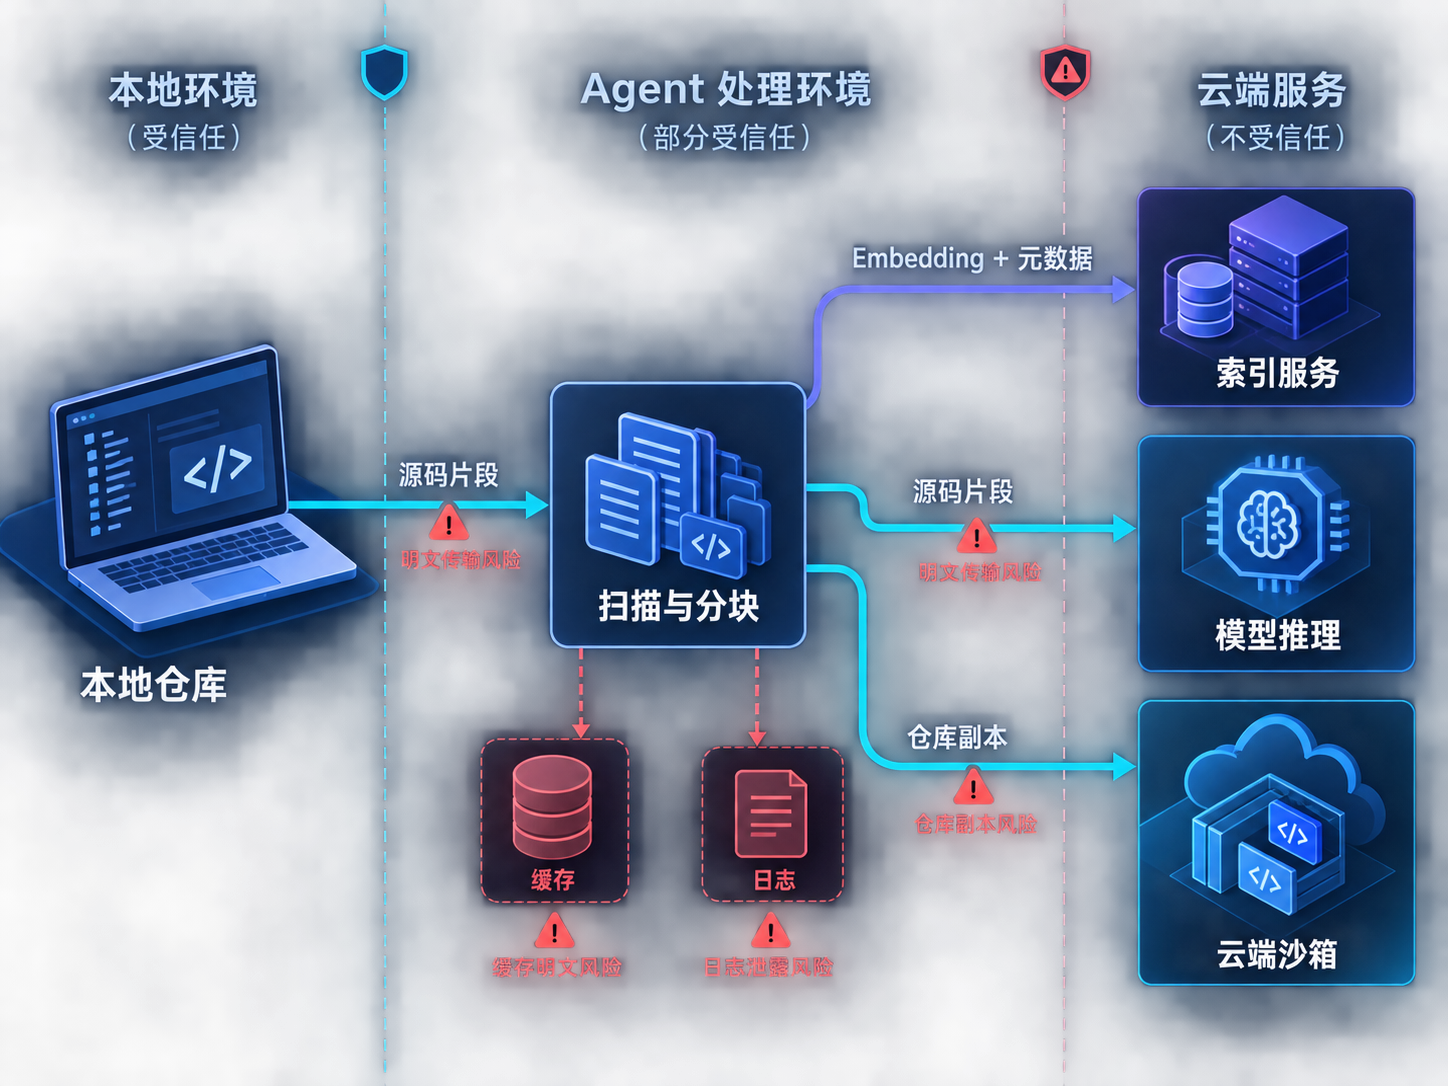
因此,同一次任务中可能同时存在五类数据:原始源码、代码向量、文件名与哈希等元数据、聊天与工具日志、云端工作副本。它们可能由不同服务保存,适用不同期限和合同条款。只问“代码有没有被上传”太粗;更有用的问题是“哪些字节,在什么时刻,被发给哪个处理者,保存多久,谁能访问,能否删除”。
| 数据阶段 | 可能离开本机的内容 | 常见目的地 | 主要风险 | 应核验的问题 |
|---|---|---|---|---|
| 仓库扫描 | 文件名、路径、大小、哈希 | 产品索引后端 | 暴露项目结构和敏感文件存在性 | 是否尊重 ignore 与内容排除规则 |
| 向量化 | 代码分块或其派生表示 | embedding 服务、向量数据库 | 明文处理、向量反演和租户隔离风险 | 明文是否缓存、向量保存多久 |
| 上下文检索 | 命中的源码片段、问题、聊天历史 | 模型路由层和模型提供商 | 机密代码进入推理请求 | 是否有 ZDR、是否经过第三方模型 |
| Agent 执行 | 仓库副本、Git 历史、构建产物、日志 | 云端虚拟机或沙箱 | 数据面扩大、网络外传、凭据误入环境 | 沙箱销毁、出站网络与凭据代理策略 |
| 反馈与遥测 | 会话、错误栈、诊断包、操作指标 | 日志、支持和分析系统 | 用户主动反馈时上传更多内容 | 默认开关、脱敏方式、反馈保留期 |
四类产品的官方数据流怎么理解
Cursor:索引会同步代码,但隐私模式改变训练与缓存规则
Cursor 2026 年 1 月发布的官方技术说明写明:首次为新代码库建立索引时,索引流程会上传文件;客户端通过 Merkle tree 与服务器比较变化,文件被切成语法代码块后生成 embeddings。官方还描述了团队内部复用索引的机制,包括客户端上传用于匹配相似索引的 simhash。这里可以确认的事实是:索引并非纯本地过程,服务器参与同步、向量化和索引复用。
Cursor 的数据使用页面则把隐私模式和非隐私模式分开说明。启用 Privacy Mode 时,客户数据不用于训练,并称其模型提供商采用 ZDR 安排;同时官方指出,风控分类器触发时可能按照相应政策保存数据。页面还说明文件内容可能被临时缓存,并由客户端生成的唯一密钥加密;关闭 Privacy Mode 后,代码库数据、提示词、编辑器行为和代码片段可能被保存并用于改进功能与训练。即使使用自己的 API Key,请求仍会经过 Cursor 后端完成最终提示构建。
这意味着“BYOK”并不自动等于点对点直连模型厂商,“Privacy Mode”也不意味着绝对没有任何服务器处理或例外保留。个人用户应先检查模式状态;企业则要确认工作区管理员能否强制执行策略,以及所选模型是否被标为非 ZDR。
GitHub Copilot:GitHub 仓库索引与非 GitHub 工作区上传要分开看
GitHub 官方文档说明,Copilot 会在后台创建仓库语义索引,索引可被 GitHub 和 Visual Studio Code 中的 Copilot Chat 以及云端 Agent 使用。更值得注意的是,VS Code 可以为 GitLab 或纯本地仓库建立语义索引,而官方明确写明:该功能会把数据上传到 GitHub,使其可搜索。对 Business 和 Enterprise,非 GitHub 仓库的语义索引受策略控制且默认禁用,需要组织或企业管理员明确开启。
GitHub 还提供内容排除策略,但文档说明它控制的是进入 Copilot Chat 的数据过滤。安全团队不应把它当作通用 DLP:需要实际验证索引构建、聊天上下文、Agent 执行、扩展日志和 BYOK 模型路径是否都遵守同一规则。个人订阅与组织订阅的数据训练设置也可能不同,应以当前计划和账户设置为准。
Claude Code:执行可以在本地,推理数据仍会走网络
Anthropic 官方文档对“local”给出了容易被忽略的边界:Claude Code 在本地运行和执行工具,但为与 LLM 交互,会通过网络发送用户提示与模型输出;任务所需的文件内容可成为提示上下文。客户端还会在本机以明文形式保存会话记录,默认位置和清理周期由文档给出,因此本机磁盘本身也是一个数据泄露面。
对商业用户,Anthropic 表示默认不使用商业条款下发送的代码或提示训练生成模型,除非客户明确选择提供数据。标准保留、合格企业账户的 ZDR、Bedrock、Google Cloud 或其他托管渠道又有不同边界。云端会话则会把仓库克隆到隔离 VM;代码和会话数据遵循账户对应的保留与使用政策。主动使用 /feedback、/bug 或分享流程,还可能上传会话及代码内容并适用更长的反馈保留规则。
所以,“Claude Code 是本地工具”只能说明工具执行位置,不能推出“源码不会发送给远端模型”或“会话不会落盘”。
OpenAI Codex:云端任务会预载仓库,训练规则取决于账户类型
OpenAI 对 Codex 的官方介绍明确说明,云端任务在独立隔离环境中运行,并预加载用户仓库;Agent 可以读写文件、执行测试、提交变更并展示终端日志。换言之,使用 Codex Cloud 时,仓库工作副本进入 OpenAI 管理的云端执行环境不是“索引副作用”,而是产品完成任务的设计前提。
数据用途要按计划判断。OpenAI 的企业数据页面说明,ChatGPT Business、Enterprise、Edu 和 API 的输入输出默认不用于训练;个人计划中,通过 Codex 处理的内容受 ChatGPT 数据控制设置影响。即便“不训练”,仍要进一步查看会话删除、标准保留、合规日志以及所连接应用的数据范围,不能把训练开关当成唯一隐私控制。
Indexing、RAG 与 Cloud Agent 的边界
从工程角度看,索引是一套“预处理与查找”机制,RAG 是“检索并把命中内容送入模型”的过程,Cloud Agent 是“在远端环境中持续读写和执行仓库”的运行模式。三者可能组合使用,但权限与数据面依次扩大。
索引层通常保存 embedding 和检索所需元数据。embedding 不是原始文本,却也不应被当作完全匿名:它能表达代码语义,还可能与文件路径、行号、仓库和租户标识关联。推理层拿到的是检索后的少量原文,但多轮对话、自动工具调用和上下文压缩可能让更多代码陆续进入请求。云端 Agent 则可能需要完整工作树、依赖清单、测试数据和构建缓存。
因此企业数据分级可以这样落地:公开代码允许云端 Agent;内部代码允许受控索引和推理;机密代码只允许批准的企业租户、区域与 ZDR;受监管或核心算法仓库默认禁用外部索引,改用自托管检索或隔离开发环境。这个分级属于实施建议,不代表任何厂商的官方合规结论。
如何实际检查自己的源码去了哪里
以下步骤适用于安全负责人、开发团队和个人开发者。不要只看营销页面,应同时检查客户端设置、组织策略、网络流量和合同附件。
- 列出实际使用方式。 记录 IDE 插件、CLI、网页 Agent、云端任务、代码审查机器人、BYOK 和第三方模型,不要只写产品名称。
- 建立测试仓库。 放入可识别但无价值的哨兵字符串,例如
CANARY_CODE_INDEX_2026_A7,禁止使用真实密钥、客户数据或生产源码。 - 查看索引范围。 检查产品的索引状态、ignore 文件、内容排除策略和管理员开关,确认被排除目录不会进入检索结果。
- 观察网络目的地。 在得到组织授权的测试环境中,通过企业代理、DNS 日志或端点网络监控识别连接域名、区域和传输时间;不要进行中间人解密,除非合规与证书策略明确允许。
- 分开测试功能。 依次测试普通补全、仓库问答、语义索引、Agent 模式、云端任务和反馈提交,比较每种模式的数据流差异。
- 核对账户与策略。 确认个人计划、企业计划、Privacy Mode、训练开关、ZDR、模型白名单和非 GitHub 仓库索引策略,保存设置证据。
- 验证删除与回退。 删除索引或会话、撤销仓库连接、轮换临时凭据,并确认管理员审计日志能记录这些操作。
- 形成处理者清单。 将产品厂商、云服务、模型提供商、日志与错误跟踪服务纳入供应商评估,标注数据区域、保留和分包商。
如果测试发现排除规则未生效、未知域名接收代码、个人账户处理机密仓库,或无法解释索引删除后的剩余数据,应暂停该模式,而不是继续扩大使用范围。
一份可落地的最小安全配置
个人开发者至少应启用隐私或“不用于训练”设置,把 .env、私钥、生产导出、客户数据、移动签名证书和基础设施状态文件加入工具支持的忽略规则。注意:.gitignore 是否被某款工具作为索引排除依据必须以其官方文档和实测为准,不能想当然。敏感信息应由 Secret Manager 在运行时注入,仓库中只保留 YOUR_API_KEY 之类占位符。
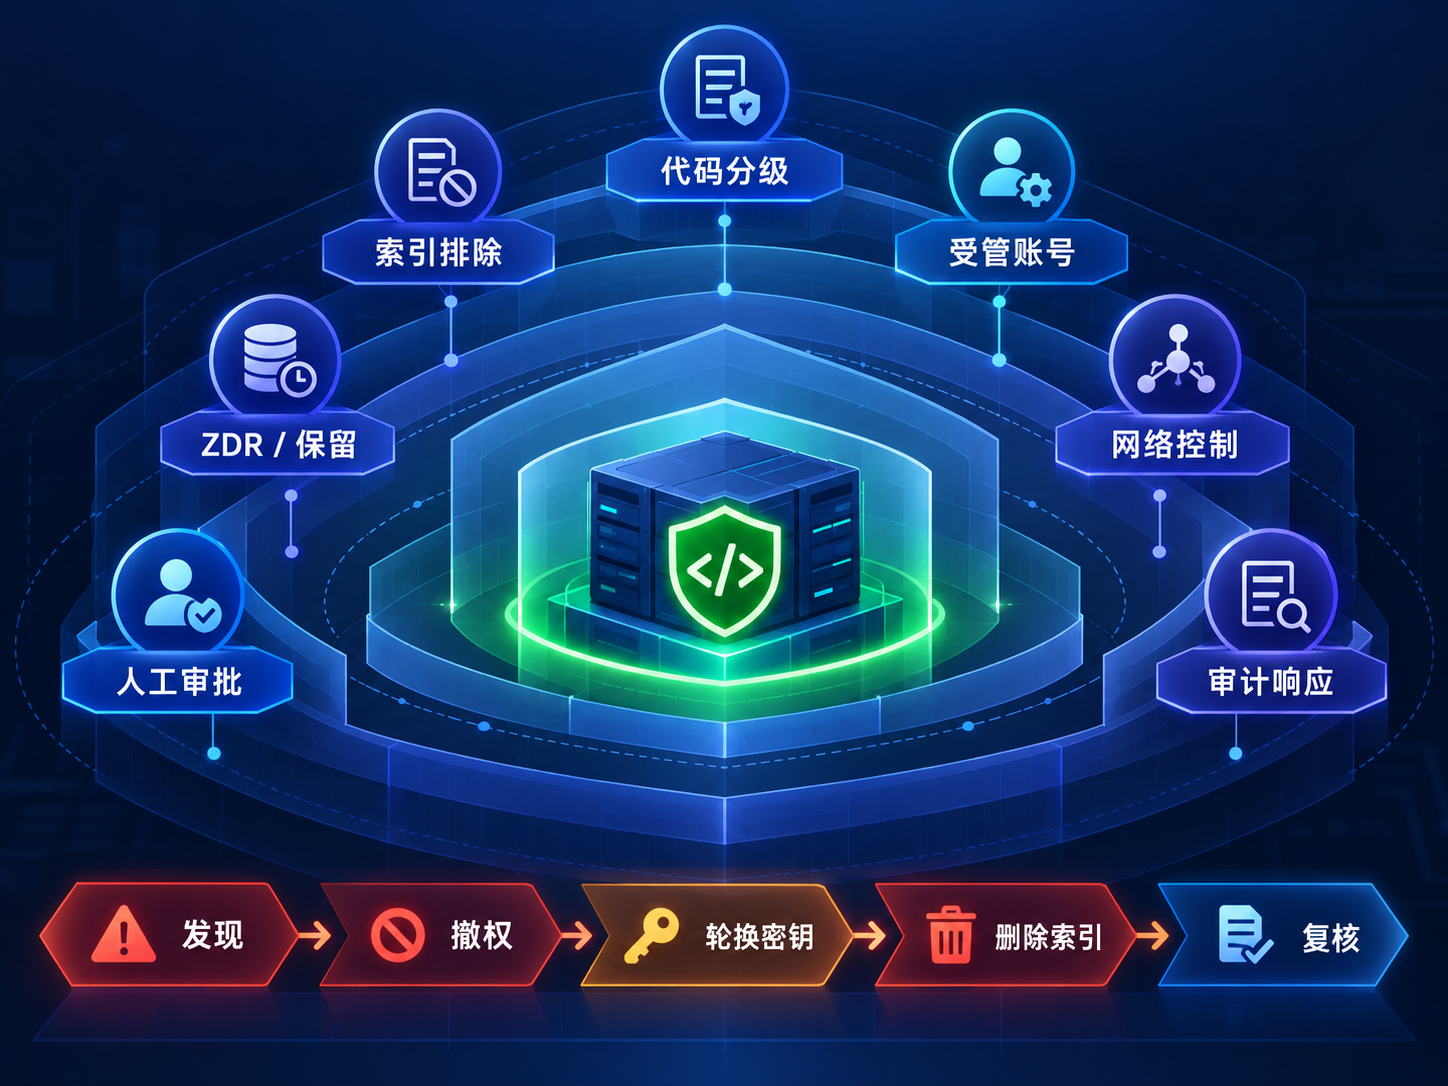
企业工作区应进一步配置:强制使用受管账号;禁止成员用个人订阅处理公司仓库;默认关闭非 GitHub 本地仓库索引;建立允许模型列表;限制 Agent 出站网络;使用短期 GitHub App 或代理凭据;对写入主分支、发布、删除和基础设施变更增加人工审批;把会话、权限变更和仓库连接写入审计日志。
可以将仓库策略表达成一份机器可读清单,供入职检查和 CI 验证使用:
coding_agent_policy:
  data_class: confidential
  managed_account_required: true
  cloud_indexing: approved_providers_only
  model_training: disabled
  zero_data_retention: required_where_available
  excluded_paths:
    - ".env*"
    - "secrets/**"
    - "customer-data/**"
    - "*.pem"
    - "*.p12"
  cloud_agent:
    outbound_network: allowlist
    production_credentials: forbidden
    destructive_actions: human_approval
  audit:
    session_logs: required
    retention_days: YOUR_RETENTION_DAYS
这份 YAML 不是任何厂商的原生配置,而是治理模板。真正实施时,需要映射到 Cursor 团队策略、GitHub Copilot 企业策略、Claude 或云提供商合同控制、OpenAI 工作区设置和企业代理规则。
泄露发生后如何处置与回滚
如果敏感源码或凭据已进入未批准的 Coding Agent,不要把“关闭索引”当作完整处置。索引可能包含派生向量,聊天可能保存命中片段,云端 Agent 可能已有工作副本,工具日志还可能记录命令输出。
第一步是冻结相关会话和客户端版本,保存管理员设置、网络日志、仓库授权和任务时间线。第二步撤销 GitHub App、OAuth、API Key、SSH Key 与云凭据;若密钥曾存在于仓库历史,应视为已暴露并轮换。第三步通过产品提供的索引、会话、连接与账户删除机制提出清除请求,同时向厂商确认派生索引、缓存、备份与支持日志的处理范围。第四步检查异常克隆、下载、分支、PR、依赖发布和出站连接。第五步在干净环境重新部署受管客户端与策略,再用无敏感测试仓库验证。
若涉及客户数据、商业秘密、个人信息或受监管数据,应让法务、隐私和事件响应团队判断通知义务。厂商“默认不训练”的声明不能代替事件分级,因为数据仍可能被处理或短期保留。
成本、性能与隐私之间的真实取舍
关闭云端索引会降低数据外流面,但也可能让大型仓库问答变慢、上下文选择变差、Token 消耗上升。自托管 embedding 和向量数据库提高控制力,却增加 GPU/CPU、存储、升级、监控、访问控制与备份成本。ZDR 和数据驻留通常依赖企业合同或合格账户,并非所有个人计划都能获得。
更现实的做法不是“一律禁用”或“一律开放”,而是按仓库分级。低敏感项目使用标准云索引;中敏感项目使用受管租户、内容排除和批准模型;高敏感项目使用隔离环境与最小上下文;最高敏感项目采用离线模型或完全自托管链路。还应为索引失败、服务不可用和策略变更设置超时、重试上限与回退方案,防止客户端在失败时静默切换到未经批准的模型或云模式。
想进一步规划 Agent 的网络边界,可参考 AI Stack Nav 的 AI Agent 网络隔离相关文章;需要统一管理工具权限和审计,可查看 MCP Gateway 与权限治理专题。
事实依据与来源
本文于 2026 年 9 月 24 日核验官方资料。官方已确认的事实包括:Cursor 新代码库索引会上传文件并生成 embeddings;Cursor Privacy Mode 与非隐私模式适用不同训练和缓存说明;GitHub Copilot 对非 GitHub 仓库的语义索引会把数据上传至 GitHub;Claude Code 本地执行仍需通过网络与模型交互,云端会话会克隆仓库到隔离 VM;Codex 云端任务在预加载仓库的隔离环境中执行。
“embedding 仍应作为敏感派生数据管理”“按仓库分级选择索引方式”“用哨兵字符串和企业代理验证数据流”属于本文的编辑判断与实施建议。各厂商的具体保留期限、数据区域、ZDR 资格、模型供应商和个人账户训练开关可能随产品与合同变化,部署前必须重新核验控制台和正式协议。本文不是法律或合规意见。
FAQ
Codebase Indexing 会把整个仓库上传吗?
不一定,但部分产品在首次建立远端索引或启动云端 Agent 时确实会上传大量文件或克隆仓库。另一些功能只发送命中的片段。应按具体功能核验,不能仅凭“智能索引”名称判断。
只保存 embedding,就可以认为源码没有泄露风险吗?
不可以。生成 embedding 的服务通常需要处理原始代码块,向量还可能与路径、行号和仓库标识关联。即使不永久保存明文,也仍存在传输、临时缓存、访问控制和派生数据保护问题。
开启“不用于训练”后,服务端会立即删除所有源码吗?
不会由这个开关自动保证。训练用途、服务保留、滥用监测、缓存、反馈与会话历史是不同控制面,必须分别查看官方数据政策和账户设置。
使用自己的 API Key 是否能绕过 Coding Agent 厂商后台?
不一定。Cursor 官方明确说明,即使 BYOK,请求仍经过其后端完成最终提示构建。其他产品也应查看网络架构,不能把 BYOK 等同于客户端直连。
Claude Code 在本地运行,源码还会发送出去吗?
本地模式下命令和文件操作可以在本机执行,但与远端 LLM 交互时,提示词、模型输出和完成任务所需的代码上下文仍会通过网络传输。使用本地模型或经批准的私有托管端点才可能改变该边界。
GitHub Copilot 会索引本地或 GitLab 仓库吗?
官方文档称,VS Code 中的语义索引可用于 GitHub 之外的工作区,并会把数据上传到 GitHub使其可搜索。Business 和 Enterprise 的这一功能受策略控制并默认禁用,需要管理员明确开启。
.gitignore 能阻止所有 Coding Agent 读取敏感文件吗?
不能一概而论。不同工具可能有自己的 ignore、内容排除与 Agent 文件访问规则;还要考虑终端命令、测试输出和构建日志。应使用产品专用排除机制并进行实际验证。
企业应该优先选择 ZDR 吗?
处理机密代码时应优先评估 ZDR,但它不是完整安全方案。仍需控制仓库授权、第三方模型、云端沙箱、出站网络、本地日志、反馈上传、人工审批和审计。
已经误把密钥上传到 Agent,删除聊天就够了吗?
不够。应立即轮换密钥和令牌,撤销相关授权,检查使用日志,再删除索引、会话和云端任务,并向厂商确认缓存、派生索引和支持日志的清除范围。
最高敏感源码应该怎样使用 Coding Agent?
默认采用离线或完全自托管模型与索引,在隔离开发环境中只开放必要目录,并禁止外网、生产凭据和自动发布。若必须使用云服务,应先完成正式供应商评估、合同控制和批准流程。
参考来源
- Cursor:Securely indexing large codebases
- Cursor:Data Use & Privacy Overview
- GitHub Docs:Repository indexing for Copilot
- Anthropic:Claude Code Data Usage
- OpenAI:Introducing Codex
- OpenAI:Business Data Privacy, Security and Compliance
内容核验日期:2026 年 9 月 24 日
工具选型与提示词资料
适合阅读工具评测、工具推荐、对比测评类文章后继续转化。

0 回复